

AI สำหรับแอป CRUD: อะไรทำได้อัตโนมัติ และอะไรต้องใช้มนุษย์
คู่มือปฏิบัติการ: สิ่งที่ AI สามารถอัตโนมัติได้อย่างเชื่อถือได้ในแอป CRUD (scaffolding, คิวรี, การทดสอบ) และจุดที่การตัดสินใจของมนุษย์เป็นสิ่งสำคัญ (โมเดล กฎ ความปลอดภัย)
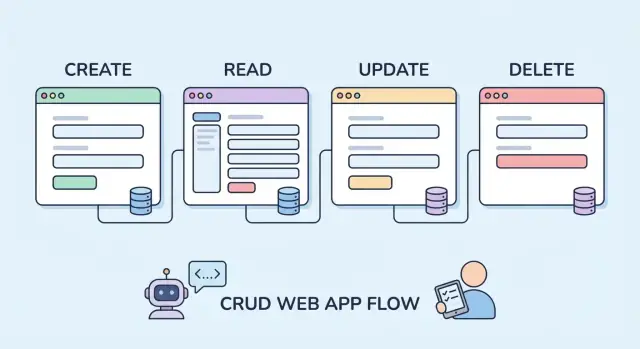
ความหมายที่แท้จริงของ “AI สำหรับ CRUD”
แอป CRUD คือเครื่องมือประจำวันที่ให้คน สร้าง อ่าน แก้ไข และลบ ข้อมูล — นึกถึงรายชื่อลูกค้า, ตัวติดตามสต็อก, ระบบนัดหมาย, แดชบอร์ดภายใน และแผงผู้ดูแลระบบ พวกมันพบได้บ่อยเพราะธุรกิจส่วนใหญ่ทำงานกับระเบียนที่มีโครงสร้างและเวิร์กโฟลว์ที่ทำซ้ำได้
เมื่อพูดว่า “AI สำหรับแอป CRUD” คนส่วนใหญ่ไม่ได้หมายถึง AI ที่วิเศษสามารถส่งมอบโปรดักต์สำเร็จรูปเองได้ พวกเขาหมายถึงผู้ช่วยที่เร่งงานวิศวกรรมซ้ำ ๆ โดยสร้าง ร่าง ที่คุณแก้ไข ตรวจทาน และเสริมความแข็งแรงได้
สิ่งที่ “อัตโนมัติได้” โดยทั่วไปเป็นอย่างไร
ในทางปฏิบัติ การอัตโนมัติของ AI ใกล้เคียงกับ:
- เสนอแนะ: แนะนำชื่อฟิลด์, endpoints, เลย์เอาต์ UI, หรือกฎการตรวจสอบตามคำบรรยายของคุณ
- ร่าง: สร้างโค้ดเริ่มต้นสำหรับโมเดล, ฟอร์ม, คอนโทรลเลอร์, มิเกรชัน และการทดสอบพื้นฐาน
- เติมเต็ม: เติมสคริปต์ที่ซ้ำ ๆ (การแมปฟิลด์, การเชื่อมเส้นทาง, ข้อความแสดงข้อผิดพลาดมาตรฐาน)
สิ่งเหล่านี้ช่วยประหยัดเวลาได้มาก—โดยเฉพาะกับ boilerplate—เพราะแอป CRUD มักเป็นรูปแบบซ้ำกัน
ความเร็ว vs ความมั่นใจ
AI ทำให้คุณเร็วขึ้น แต่ไม่ได้ทำให้ผลลัพธ์ถูกต้องโดยอัตโนมัติ โค้ดที่สร้างขึ้นอาจ:
- ตีความศัพท์ทางโดเมนผิด (เช่น “customer” vs “account”, “archived” vs “deleted”)
- ใช้ค่าพื้นฐานที่ไม่ปลอดภัย (สิทธิ์กว้างเกินไป, พลาดกรณีขอบ)
- สร้างโค้ดที่คอมไพล์ได้แต่ว่าไม่ตรงกับกฎธุรกิจของคุณ
ดังนั้นความคาดหวังที่ถูกต้องคือ เร่งความเร็ว ไม่ใช่ความแน่นอน — คุณยังคงต้องตรวจทาน ทดสอบ และตัดสินใจ
การแบ่งงานจริง: งานที่เป็นรูปแบบซ้ำ vs งานที่ต้องใช้วิจารณญาณ
AI แข็งแกร่งที่สุดที่งานมีรูปแบบและคำตอบที่ “ถูกต้อง” โดยทั่วไปเป็นมาตรฐาน: scaffolding, endpoints CRUD, ฟอร์มพื้นฐาน และการทดสอบที่คาดเดาได้
มนุษย์ยังจำเป็นในจุดที่การตัดสินใจเป็นบริบท: ความหมายของข้อมูล, การควบคุมการเข้าถึง, ความปลอดภัย/ความเป็นส่วนตัว, กรณีขอบ และกฎที่ทำให้แอปของคุณมีเอกลักษณ์
ส่วนที่ CRUD คาดเดาได้ (และส่วนที่ไม่คาดเดา)
แอป CRUD มักสร้างจากชิ้นส่วนแบบเดียวกัน: data models, migrations, forms, validation, list/detail pages, tables and filters, endpoints (REST/GraphQL/RPC), search and pagination, auth, และ permissions รูปแบบที่ซ้ำกันนี้คือเหตุผลที่การสร้างด้วย AI ให้ความรู้สึกรวดเร็ว—หลายโปรเจคมีรูปทรงคล้ายกัน แม้โดเมนธุรกิจจะต่างกัน
ส่วนที่คาดเดาได้
รูปแบบปรากฏบ่อย:
- หน้าจอ “Create/Edit” มักสะท้อนฟิลด์ของโมเดล
- หน้า index ตอบโจทย์แบบเดียวกัน: การจัดเรียง, กรอง, แบ่งหน้า
- Endpoints มักแมปกับปฏิบัติการมาตรฐาน: list, get, create, update, delete
- Validation เริ่มต้นมักเป็นการตรวจชนิด/รูปแบบ (ฟิลด์บังคับ, min/max length, รูปแบบอีเมล)
ด้วยเหตุนี้ AI จึงทำได้ดีในการผลิต ร่างแรก: โมเดลพื้นฐาน, เส้นทาง scaffolded, controllers/handlers เริ่มต้น, ฟอร์ม UI มาตรฐาน และการทดสอบเริ่มต้น มันคล้ายกับสิ่งที่ frameworks และ code generators ทำนั่นเอง—AI เพียงปรับให้เข้ากับการตั้งชื่อและคอนเวนชันของคุณได้เร็วกว่า
ส่วนที่ไม่คาดเดา
แอป CRUD หยุดเป็น “มาตรฐาน” เมื่อคุณเพิ่ม ความหมาย:
- Permissions: “ใครแก้ไขได้?” แทบไม่เคยเป็นแค่ “admin vs user.” มักเป็นเงื่อนไข (สมาชิกทีม, เจ้าของระเบียน, สถานะ, ภูมิภาค)
- ความถูกต้องของข้อมูล: ความผิดพลาดเล็กน้อยในความสัมพันธ์, กฎความเป็นเอกลักษณ์, หรือ cascading delete อาจทำให้ข้อมูลเสียหรือบล็อกเวิร์กโฟลว์ที่ถูกต้อง
- สถานะและการเปลี่ยนแปลงทางธุรกิจ: กฎ “draft → submitted → approved” ไม่ได้อยู่ใน schema ของฐานข้อมูลเพียงอย่างเดียว
- กรณีขอบ: imports, concurrency, partial updates, พฤติกรรม soft delete สามารถทำลายสมมติฐานได้
นี่คือบริเวณที่ความผิดพลาดเล็กน้อยสร้างปัญหาใหญ่: การเข้าถึงโดยไม่ได้รับอนุญาต, การลบที่ย้อนกลับไม่ได้, หรือระเบียนที่ไม่สามารถปรับให้ตรงกันได้
กฎใช้งานที่เป็นประโยชน์
ใช้ AI เพื่อ อัตโนมัติรูปแบบ แล้วตั้งใจ ตรวจสอบผลกระทบ หากผลลัพธ์มีผลต่อว่าใครเห็น/เปลี่ยนข้อมูลได้ หรือว่าข้อมูลถูกต้องตลอดเวลา ถือว่าเป็นความเสี่ยงสูงและต้องตรวจสอบเหมือนโค้ดที่สำคัญต่อโปรดักชัน
งานที่ AI ทำได้ดี: Boilerplate และ Scaffolding
AI โชว์ศักยภาพที่สุดเมื่อการงานซ้ำซ้อน โครงสร้างคาดเดาได้ และตรวจสอบง่าย แอป CRUD มีงานแบบนี้มาก: รูปแบบเดียวกันถูกใช้ซ้ำในหลายโมเดล, endpoints, และหน้าจอ ใช้ AI แบบนี้จะประหยัดชั่วโมงได้โดยไม่ทำให้ความหมายของผลิตภัณฑ์เปลี่ยน
สร้าง “รูปทรง” ของฟีเจอร์
เมื่อให้คำอธิบายชัดเจนของเอนทิตี (ฟิลด์, ความสัมพันธ์, การกระทำพื้นฐาน) AI สามารถร่างโครงได้อย่างรวดเร็ว: คำจำกัดความโมเดล, controllers/handlers, routes, และหน้าเริ่มต้น คุณยังต้องยืนยันการตั้งชื่อ, ชนิดข้อมูล, และความสัมพันธ์—แต่เริ่มจากร่างครบถ้วนเร็วกว่าการสร้างไฟล์ทุกไฟล์จากศูนย์
Boilerplate สำหรับ REST หรือ GraphQL handlers
สำหรับการปฏิบัติการทั่วไป—list, detail, create, update, delete—AI สามารถสร้างโค้ด handler ที่ตามโครงสร้างปกติ: parse input, เรียก data-access layer, ส่ง response
สิ่งนี้มีประโยชน์เมื่อคุณต้องตั้งค่า endpoints จำนวนมากที่คล้ายกันพร้อมกัน กุญแจคือตรวจสอบขอบ: filtering, pagination, error codes, และกรณีพิเศษที่ไม่ใช่มาตรฐานจริง ๆ
แดชบอร์ดผู้ดูแลและมุมมองแบบง่าย
CRUD มักต้องการเครื่องมือภายใน: หน้า list/detail พื้นฐาน, ฟอร์ม, ตาราง และ navigation สไตล์แอดมิน AI สามารถสร้างเวอร์ชันเริ่มต้นที่ใช้งานได้อย่างรวดเร็ว
ปฏิบัติกับสิ่งเหล่านี้เป็นโพรโทไทป์ที่ต้องเสริมความแข็งแรง: ตรวจสอบสถานะว่างเปล่า, สถานะการโหลด, และว่าการ UI ตรงกับวิธีที่ผู้ใช้ค้นหาและสแกนข้อมูลจริงหรือไม่
รีแฟคเตอร์โค้ดซ้ำอย่างปลอดภัย
AI มีประโยชน์อย่างน่าประหลาดใจในการรีแฟคเตอร์เชิงกลไก: เปลี่ยนชื่อฟิลด์ทั่วไฟล์, ย้ายโมดูล, ดึง helper, หรือทำให้รูปแบบเป็นมาตรฐาน (เช่น การแยกการ parse คำร้องขอหรือการฟอร์แมต response) มันยังแนะนำจุดที่มีการทำซ้ำ
อย่างไรก็ตาม คุณควรรันเทสต์และตรวจ diff — รีแฟคเตอร์ล้มเหลวได้แบบลวงเมื่อสองกรณีที่ดู “คล้าย” กันจริง ๆ แล้วไม่เท่ากัน
เอกสารเริ่มต้นและคอมเมนต์ (ต้องทบทวน)
AI สร้าง README, คำอธิบาย endpoint, และคอมเมนต์เชิงอธิบายได้ ซึ่งช่วย onboarding และการทบทวนโค้ด—ตราบใดที่คุณยืนยันสิ่งที่มันอ้าง บันทึกหรือเอกสารที่ผิดอาจแย่กว่าที่ไม่มีเลย
Data Models และ Migrations: ร่างช่วยได้ แต่มีสมมติฐานที่เสี่ยง
AI มีประโยชน์เมื่อเริ่มการออกแบบข้อมูลเพราะมันแปลงเอนทิตีที่อธิบายเป็นภาษาธรรมดาให้เป็นสคีมาคร่าว ๆ ได้ดี หากคุณอธิบาย “Customer, Invoice, LineItem, Payment” มันสามารถร่างตาราง/คอลเลกชัน, ฟิลด์ทั่วไป, และดีฟอลต์ที่สมเหตุสมผล (IDs, timestamps, status enums)
จุดที่ AI ช่วยทันที
สำหรับการเปลี่ยนแปลงธรรมดา AI ช่วยงานน่าเบื่อได้เร็ว:
- ร่างแนวเสนอ schema เบื้องต้นจากเอนทิตีที่อธิบาย
- สร้างมิเกรชันสำหรับการเพิ่ม/เปลี่ยนชื่อฟิลด์ง่าย ๆ
- แนะนำดัชนีสำหรับการกรอง/เรียงที่พบบ่อย (เช่น:
tenant_id + created_at,status,email) — แต่ต้องตรวจสอบกับคิวรีจริง
สิ่งนี้เป็นประโยชน์เมื่อคุณกำลังสำรวจ: คุณสามารถวนรอบโมเดลอย่างรวดเร็ว แล้วค่อยกระชับเมื่อเวิร์กโฟลว์ชัดเจนขึ้น
จุดที่มักพลาด
โมเดลข้อมูลซ่อน “กับดัก” ที่ AI ไม่สามารถอนุมานได้จาก prompt สั้น ๆ:
- ความสัมพันธ์: one-to-many vs many-to-many, optional vs required, และความหมายของ “ownership”
- Cascading deletes: ควรเกิดอะไรเมื่อ parent ถูกลบ — hard delete, soft delete, restrict, archive, หรือ reassign
- Multi-tenant: อะไรต้อง scoped ต่อ tenant, วิธีป้องกันการอ่านข้าม tenant, และข้อจำกัด unique ควรเป็น “unique per tenant” หรือ global
นี่ไม่ใช่ปัญหาทางไวยากรณ์ แต่นี่คือการตัดสินใจด้านธุรกิจและความเสี่ยง
การตรวจโดยคน: การเปลี่ยนแปลงที่ปลอดภัยกับข้อมูลโปรดักชัน
มิเกรชันที่ “ถูกต้อง” อาจยังไม่ปลอดภัย ก่อนรันบนข้อมูลจริง คุณต้องตัดสินใจ:
- การเปลี่ยนนี้จะเขียนซ้ำตารางใหญ่หรือปิดกั้นการเขียนหรือไม่?
- มีแถวเก่าที่ไม่เป็นไปตามข้อจำกัดใหม่หรือไม่?
- ควรแยกเป็น expand/migrate/contract หรือไม่?
ใช้ AI ร่างมิเกรชันและแผน rollout แต่ถือว่าแผนเป็นข้อเสนอ — ทีมของคุณเป็นเจ้าของผลลัพธ์
ฟอร์มและการตรวจสอบ: สร้างได้เร็ว แต่ความหมายต้องระมัดระวัง
ฟอร์มคือจุดที่ CRUD พบกับมนุษย์ AI มีประโยชน์จริงเพราะงานซ้ำ: แปลงสคีมาเป็นอินพุต, เชื่อมการตรวจสอบพื้นฐาน, และรักษาความสอดคล้องระหว่าง client และ server
สิ่งที่ AI สร้างได้ดี
เมื่อให้โมเดลข้อมูลหรือ JSON ตัวอย่าง AI สามารถร่างได้เร็ว:
- ฟิลด์ฟอร์มแมปกับชนิดทั่วไป (text, number, date, select, checkbox)
- คอมโพเนนต์ UI พื้นฐานพร้อมป้ายกำกับ, placeholder, และค่าเลย์เอาต์เริ่มต้น
- ตัวตรวจสอบพื้นฐาน: required, min/max, length limits, รูปแบบอีเมล/URL
- สตับการตรวจสอบแบบคู่ขนานทั้งฝั่ง client และ server
สิ่งนี้เร่งให้ได้ "เวอร์ชันใช้งานได้ครั้งแรก" อย่างมาก โดยเฉพาะหน้าจอสไตล์แอดมินทั่วไป
ความหมายที่ซับซ้อน
การตรวจสอบไม่ใช่แค่ปฏิเสธข้อมูลไม่ดี แต่มันคือการสื่อความตั้งใจ AI ไม่สามารถอนุมานได้อย่างเชื่อถือว่า "ดี" สำหรับผู้ใช้ของคุณคืออะไร
คุณยังต้องตัดสินใจเรื่อง:
- ข้อความแสดงข้อผิดพลาดที่เหมาะสม: ชัดเจน เฉพาะเจาะจง และสอดคล้องกับโทนของคุณ (และเข้าถึงได้สำหรับ screen reader)
- UX ที่ครอบคลุม: ชื่อ, ที่อยู่, เบอร์โทรมีความแตกต่างสูง; “invalid” อาจเป็นการตัดสินใจของผลิตภัณฑ์ ไม่ใช่เทคนิค
- กรณีขอบ: ชื่อกลางที่เป็นทางเลือก, ปฏิทินนอกGregorian, ค่าศูนย์ที่มีความหมาย, หรือเวิร์กโฟลว์ “N/A”
โหมดความล้มเหลวทั่วไปคือ AI บังคับกฎที่ดูสมเหตุสมผลแต่ไม่ถูกต้องสำหรับธุรกิจของคุณ (เช่น บังคับรูปแบบเบอร์โทรเข้มงวดหรือปฏิเสธอักขระคำย่อในชื่อ)
กฎควรอยู่ที่ไหน
AI เสนอทางเลือกได้ แต่คุณเป็นคนเลือกแหล่งความจริง:
- UI validation เพื่อฟีดแบ็กทันที (แต่ไม่เคยเป็นเกตเพียงอย่างเดียว)
- API validation เพื่อความสอดคล้องระหว่างเว็บ, มือถือ, การนำเข้า, และการรวม
- Database constraints สำหรับ invariants ที่ต้องไม่ละเมิด (unique keys, foreign keys, non-null)
แนวปฏิบัติ: ให้ AI สร้างร่างแรก แล้วทบทวนแต่ละกฎและถามว่า “นี่เป็นความสะดวกให้ผู้ใช้, ข้อตกลง API, หรือข้อบังคับข้อมูลที่ต้องไม่ผิดพลาด?”
API และตรรกะการคิวรี: งานที่มีรูปแบบแต่ขอบคม
API CRUD มักตามรูปแบบที่ทำซ้ำ: list records, fetch by ID, create, update, delete, และบางครั้ง search นั่นทำให้เป็นพื้นที่หวานสำหรับความช่วยเหลือของ AI—โดยเฉพาะเมื่อคุณต้องการ endpoints แบบคล้ายกันจำนวนมาก
จุดที่ AI ช่วยได้มากที่สุด
AI มักถนัดร่าง list/search/filter endpoints และ "kleu code" รอบ ๆ พวกมัน เช่น:
- ชุด endpoints ที่สอดคล้องกัน (
GET /orders,GET /orders/:id,POST /orders, ฯลฯ) - โครงสร้าง query-builder สำหรับตัวกรองอย่าง status, date ranges, และการค้นหาด้วยข้อความ
- โค้ดแมป (DTOs, serializers, view models) เพื่อให้ response ดูสอดคล้องกันทั่ว endpoints
จุดหลังสำคัญกว่าที่คิด: รูปร่าง API ที่ไม่สอดคล้องกันสร้างงานซ่อนสำหรับทีม front-end และการรวมระบบ AI ช่วยบังคับรูปแบบเช่น “คืน { data, meta } เสมอ” หรือ “วันที่เป็น ISO-8601 เสมอ”
Pagination และการจัดเรียง: รูปแบบเร็ว แต่ต้องแลกจริง
AI สามารถเพิ่ม pagination และการจัดเรียงได้เร็ว แต่จะไม่เลือกกลยุทธ์ที่ใช่สำหรับข้อมูลของคุณโดยอัตโนมัติ
Offset pagination (?page=10) ใช้ง่าย แต่ช้าและไม่คงที่เมื่อข้อมูลเปลี่ยน ส่วน cursor pagination (ใช้ token "next cursor") ทำงานดีกว่าในสเกล แต่ยากกว่าเมื่อต้องจัดเรียงหลายฟิลด์
คุณยังต้องตัดสินใจว่า "ถูกต้อง" หมายถึงอะไรสำหรับผลิตภัณฑ์ของคุณ: การเรียงลำดับคงที่, ผู้ใช้ต้องย้อนดูได้ไกลแค่ไหน, และจะทนค่าการนับที่แพงได้หรือไม่
กับดักทั่วไปที่ AI อาจพลาด
โค้ดคิวรีคือที่ที่ความผิดพลาดเล็ก ๆ กลายเป็นการล่มใหญ่ โค้ด API ที่สร้างโดย AI มักต้องการการตรวจทานเพื่อ:
- N+1 queries (วนลูปแล้วดึงความสัมพันธ์ทีละรายการ)
- ขาด limits (รายการไม่มีขอบ, การค้นหาที่หนักหน่วง, endpoints ที่ดาวน์โหลดทุกอย่าง)
- ตัวกรองหรือการจัดเรียงแบบไดนามิกที่ไม่ปลอดภัย (แทรก input ของผู้ใช้ลงในคิวรีโดยตรง)
การทบทวนโดยมนุษย์: ตั้งความคาดหวังด้านประสิทธิภาพ
ก่อนยอมรับโค้ดที่สร้าง ตรวจสอบกับปริมาณข้อมูลจริง: ลูกค้าทั่วไปจะมีระเบียนกี่รายการ? “ค้นหา” หมายถึงอะไรที่ 10k เทียบกับ 10M แถว? endpoints ไหนต้องการดัชนี, caching, หรือตีกรอบ rate limits? AI ร่างรูปแบบได้ แต่คนต้องตั้ง guardrails: งบประมาณประสิทธิภาพ, กฎคิวรีปลอดภัย, และสิ่งที่ API ทำได้ภายใต้โหลด
การทดสอบ: AI สร้างเทสได้เยอะ แต่คุณเป็นคนเลือกเทสที่สำคัญ
AI น่าประหลาดใจในการผลิตโค้ดเทสได้เร็ว—โดยเฉพาะในแอป CRUD ที่รูปแบบซ้ำ แต่กับดักคือคิดว่า “เทสเยอะ = คุณภาพดี” โดยอัตโนมัติ AI ผลิตปริมาณ; คุณต้องเลือกสิ่งที่สำคัญ
จุดที่ AI ช่วยทันที
ถ้าคุณให้ AI signature ของฟังก์ชัน, คำอธิบายสั้น ๆ ของพฤติกรรมที่คาดหวัง, และตัวอย่างไม่กี่รายการ มันสามารถร่าง unit tests ได้เร็ว มันยังทำ integration tests แบบ happy-path สำหรับฟลูว์ทั่วไปเช่น “create → read → update → delete” ได้ดี รวมทั้งจัดการการเรียก, ตรวจรหัสสถานะ, และตรวจรูปแบบ response
การใช้ที่ดีอีกอย่างคือร่าง test data: factories/fixtures (users, records, entities ที่เกี่ยวข้อง) และรูปแบบ mocking (เวลา, UUIDs, การเรียกภายนอก) เพื่อไม่ต้องเขียน setup ซ้ำ ๆ
สิ่งที่มนุษย์ต้องตัดสิน
AI มักมุ่งไปที่ตัวเลข coverage และกรณีชัดเจน งานของคุณคือเลือกกรณีที่มีความหมาย:
- Regressions: เทสที่ล็อกบั๊กที่เคยเกิด
- Permissions: ตรวจว่าใครอ่าน/สร้าง/แก้/ลบได้และใครไม่ได้
- Concurrency: อัปเดตพร้อมกัน, เขียนข้อมูลเก่า, idempotency, ส่งซ้ำ
- Failures: input ไม่ถูกต้อง, ความสัมพันธ์ขาด, ข้อผิดพลาดฐานข้อมูล, timeout เครือข่าย, และความสำเร็จบางส่วน
กฎปฏิบัติ: ให้ AI ร่างรอบแรก แล้วทบทวนเทสแต่ละชิ้นและถามว่า “เทสนี้จะจับปัญหาในโปรดักชันจริงหรือไม่?” ถ้าคำตอบว่า “ไม่” ให้ลบทิ้งหรือเขียนใหม่ให้ปกป้องพฤติกรรมจริง
การยืนยันตัวตนและการกำหนดสิทธิ์: AI ช่วยได้ แต่มนุษย์รับความเสี่ยง
Authentication (ใครเป็นผู้ใช้) มักตรงไปตรงมาใน CRUD แต่ Authorization (เขาทำอะไรได้บ้าง) คือที่โครงการมักถูกแทรกซ้อน, ถูกตรวจสอบ, หรือรั่วข้อมูลเป็นเวลานาน AI เร่งงานเชิงกลไก แต่ไม่สามารถรับผิดชอบความเสี่ยงได้
จุดที่ AI ช่วยได้ทันที
ถ้าคุณให้ข้อกำหนดชัดเจน (“Managers แก้ไขได้ทุกคำสั่ง; customers ดูได้เฉพาะของตัวเอง; support คืนเงินได้แต่แก้ที่อยู่ไม่ได้”) มันสามารถร่าง RBAC/ABAC ชั้นแรกและแมปไปยังบทบาท, แอตทริบิวต์, และทรัพยากรได้ ถือเป็นสเก็ตช์เริ่มต้น ไม่ใช่คำตัดสินสุดท้าย
AI ยังช่วยสแกนหา authorization ที่ไม่สอดคล้อง โดยเฉพาะในฐานโค้ดที่มีหลาย handlers/controllers มันสามารถหา endpoints ที่มีการ authenticate แต่ลืม enforce permissions หรือ actions ที่เป็น “admin-only” แต่ขาด guard ในเส้นทางใดเส้นทางหนึ่ง
สุดท้าย มันสร้าง plumbing: middleware stubs, policy files, decorators/annotations, และเช็ก boilerplate
จุดที่มนุษย์ต้องตัดสิน
คุณยังต้องกำหนด threat model (ใครอาจจะเอาเปรียบระบบ), ค่าเริ่มต้น least-privilege (เกิดอะไรขึ้นเมื่อบทบาทหายไป), และความต้องการ audit (อะไรต้องถูกบันทึก, เก็บไว้, และทบทวน) การตัดสินเหล่านี้ขึ้นกับธุรกิจของคุณ ไม่ใช่ framework
เช็คลิสต์รีวิวด่วน
- ทุกเส้นทางอ่านได้รับการปกป้อง (list, search, export, “download CSV,” background jobs)
- ทุกเส้นทางเขียนได้รับการปกป้อง (create, update, delete, bulk actions, imports)
- กฎความเป็นเจ้าของถูกบังคับฝั่งเซิร์ฟเวอร์ (อย่าเชื่อ hidden form fields)
- การกระทำที่มีสิทธิ์ถูกบันทึกพร้อม who/what/when (และถ้าเป็นไปได้ why)
AI ช่วยให้ถึงจุด “implemented” ได้ แต่只有คุณเท่านั้นที่จะพาไปสู่ “ปลอดภัย”
การจัดการข้อผิดพลาดและการสังเกตการณ์: ค่าดีฟอลต์ที่ดี แต่การตัดสินยากต้องมนุษย์
AI ช่วยงานนี้ได้เพราะการจัดการข้อผิดพลาดและ observability เป็นรูปแบบที่คุ้นเคย มันสามารถตั้งค่าค่าดีฟอลต์ที่ "พอใช้" ได้เร็ว—แล้วคุณค่อยปรับให้ตรงกับโปรไฟล์ความเสี่ยงและสิ่งที่ทีมต้องรู้ตอนตีสอง
สิ่งที่ AI ร่างได้อย่างเชื่อถือ
AI แนะนำชุดปฏิบัติการพื้นฐานได้:
- การล็อกพื้นฐานรอบคำร้อง, การเรียกฐานข้อมูล, และการเรียก API ภายนอก
- รูปแบบ retry สำหรับ dependency ที่ไม่เสถียร (พร้อม backoff และจำนวนครั้งสูงสุด)
- รหัสสถานะที่สอดคล้องและ structured error responses
ตัวอย่างรูปแบบ error API ที่ AI อาจสร้างเริ่มต้นอาจเป็น:
{
  "error": {
    "code": "VALIDATION_ERROR",
    "message": "Email is invalid",
    "details": [{"field": "email", "reason": "format"}],
    "request_id": "..."
  }
}
ความสม่ำเสมอนี้ช่วยให้แอปไคลเอนต์สร้างและซัพพอร์ตได้ง่ายขึ้น
Metrics และแดชบอร์ด: ร่างเริ่มต้นที่ดี
AI เสนอชื่อ metrics และแดชบอร์ดเริ่มต้นได้: request rate, latency (p50/p95), error rate ตาม endpoint, queue depth, เวลาในฐานข้อมูล ให้ถือเป็นไอเดียเริ่มต้น ไม่ใช่กลยุทธ์การมอนิเตอร์ที่เสร็จสมบูรณ์
การตัดสินยากเป็นงานมนุษย์
สิ่งที่เสี่ยงไม่ใช่การเพิ่ม logs แต่คือการเลือกที่จะไม่เก็บ คุณต้องตัดสินใจ:
- อะไรปลอดภัยที่จะล็อก (และอะไรต้องไม่ล็อก): รหัสผ่าน, โทเคน, ข้อมูลส่วนบุคคล, รายละเอียดการชำระเงิน
- จะจัดการ PII อย่างไร: การแดงข้อความ, แฮช, หรือเลี่ยงการเก็บ
- การเก็บข้อมูล: เก็บ logs และ traces นานแค่ไหน และใครเข้าถึงได้
สุดท้าย กำหนดว่า “สุขภาพ” หมายถึงอะไรสำหรับผู้ใช้ของคุณ: “การชำระเงินสำเร็จ”, “โปรเจคถูกสร้าง” , “อีเมลส่งถึง” ไม่ใช่แค่ “เซิร์ฟเวอร์ยัง up” นิยามนี้ขับเคลื่อน alerts ที่บอกผลกระทบลูกค้าจริงแทนที่จะเป็นเสียงรบกวน
กฎธุรกิจ: ส่วนที่ AI ไม่อาจรู้โดยไม่มีคุณ
แอป CRUD ดูเรียบง่ายเพราะหน้าจอคุ้นเคย: สร้างระเบียน, อัพเดตฟิลด์, ค้นหา, ลบ ส่วนที่ยากคือสิ่งที่องค์กรของคุณ หมายถึง โดยการกระทำนั้นๆ
AI สามารถสร้าง controllers, ฟอร์ม, และโค้ดฐานข้อมูลได้เร็ว—แต่ไม่สามารถอนุมานกฎที่ทำให้แอปของคุณถูกต้องสำหรับธุรกิจนั้นได้ กฎเหล่านี้อยู่ในเอกสารนโยบาย, ความรู้ภายใน, และการตัดสินใจกรณีขอบที่คนทำทุกวัน
แปลงงานจริงเป็นโค้ด
เวิร์กโฟลว์ CRUD ที่เชื่อถือได้มักซ่อนต้นไม้การตัดสินใจ:
- ใครสร้าง/แก้/ยกเลิกได้บ้าง?
- อะไรนับว่า “อนุมัติ” และเกิดอะไรขึ้นเมื่อถูกปฏิเสธ?
- ข้อยกเว้นไหนยอมรับได้ และใครให้สิทธิ์ยกเว้น
การอนุมัติเป็นตัวอย่างที่ดี “ต้องการผู้จัดการอนุมัติ” ฟังดูตรงไปตรงมาจนกว่าคุณจะนิยาม: ถ้าผู้จัดการลาหยุด, จำนวนเงินเปลี่ยนหลังอนุมัติ, หรือคำขอข้ามสองแผนกจะทำอย่างไร? AI ร่างสเตตแมชชีนสำหรับการอนุมัติได้ แต่คุณต้องนิยามกฎ
ความคลุมเครือและความขัดแย้งในข้อกำหนด
ผู้มีส่วนได้ส่วนเสียมักไม่เห็นด้วยโดยไม่รู้ตัว ทีมหนึ่งต้องการ “การประมวลผลเร็ว” อีกทีมต้องการ “การควบคุมเข้มงวด” AI จะทำตามคำสั่งที่ชัดเจนที่สุดหรือคำสั่งล่าสุดที่ระบุไว้
มนุษย์ต้องไกล่เกลี่ยความขัดแย้งและเขียนแหล่งความจริงเดียว: กฎคืออะไร, ทำไมถึงมี, และความสำเร็จคืออะไร
คำจำกัดความที่ป้องกันความสับสนในอนาคต
การเลือกชื่อเล็ก ๆ สร้างผลกระทบใหญ่ ข้อนี้ควรตกลงก่อนรันโค้ด:
- Statuses (draft, submitted, approved, fulfilled, archived)
- Timestamps (created_at, submitted_at, approved_at) และว่าสามารถเป็นอ็อปชันได้หรือไม่
- Ownership (ใคร “เป็นเจ้าของ” ระเบียนในแต่ละขั้นตอนและใครย้ายได้)
เลือกแลกเปลี่ยนอย่างมีจุดมุ่งหมาย
กฎธุรกิจบังคับให้ต้องเลือก: ความเรียบง่าย vs ความยืดหยุ่น, ความเข้มงวด vs ความเร็ว AI เสนอทางเลือกได้ แต่มันไม่รู้ระดับความเสี่ยงที่คุณยอมรับ
แนวทางปฏิบัติ: เขียน 10–20 ตัวอย่างกฎเป็นภาษาธรรมดา (รวมข้อยกเว้น) แล้วให้ AI แปลเป็นการตรวจสอบ, การเปลี่ยนสถานะ, และข้อจำกัด—จากนั้นคุณตรวจทานทุกกรณีขอบเพื่อหาผลลัพธ์ที่ไม่ตั้งใจ
ความปลอดภัย, ความเป็นส่วนตัว และการปฏิบัติตามข้อกำหนด: ต้องมีการกำกับดูแลจากมนุษย์
AI สร้างโค้ด CRUD ได้เร็ว แต่ความปลอดภัยและการปฏิบัติตามข้อกำหนดไม่ทำงานแบบ "พอใช้" โค้ดตัวอย่างที่เก็บระเบียนและคืน JSON อาจดูดีในเดโม—แต่ยังสร้างช่องโหว่ในโปรดักชันได้ ให้ถือว่าเอาต์พุตจาก AI เป็นสิ่งที่ยังไม่เชื่อถือได้จนกว่าจะได้รับการตรวจทาน
รูปแบบเสี่ยงที่ AI อาจแนะนำโดยไม่ตั้งใจ
ปัญหาทั่วไปปรากฏในโค้ดที่ดูสะอาด:
- Mass assignment: รับออบเจกต์คำร้องทั้งก้อนแล้ว persist อาจเปิดให้ผู้ใช้ตั้งฟิลด์ที่ไม่ควร (เช่น
role=admin,isPaid=true) - Injection risks: การสร้างคิวรีด้วยสตริง, filters ที่ไม่ escape, หรือ endpoints search ที่ไม่ปลอดภัย สามารถนำไปสู่ SQL/NoSQL injection
- การอัปโหลดไฟล์ที่ไม่ปลอดภัย: ขาดการตรวจประเภทไฟล์, เก็บไฟล์ในพาธสาธารณะ, หรือข้ามการสแกนมัลแวร์
การควบคุมการเข้าถึงที่แตกและการรั่วไหลของข้อมูล
แอป CRUD ล้มเหลวบ่อยที่สุดที่รอยต่อ: endpoints รายการ, “export CSV”, มุมมองแอดมิน, และการแยก tenant AI อาจลืม scope คิวรี (เช่น โดยไม่มี account_id) หรือสมมติว่า UI ป้องกันการเข้าถึง มนุษย์ต้องตรวจสอบ:
- ทุกเส้นทางอ่าน/เขียนบังคับ authorization ฝั่งเซิร์ฟเวอร์
- ข้อความแสดงข้อผิดพลาดและ logs ไม่รั่วฟิลด์ที่ละเอียดอ่อน
- Pagination, search, และ bulk actions ไม่สามารถ enumerate ข้อมูลของผู้ใช้คนอื่น
การปฏิบัติตามข้อกำหนดไม่ใช่สคริปต์โค้ดเดียว
ข้อกำหนดเช่น การพำนักข้อมูล, audit trails, และ ความยินยอม ขึ้นกับธุรกิจ, ภูมิศาสตร์, และสัญญา AI เสนอรูปแบบได้ แต่คุณต้องกำหนดว่า “compliant” หมายถึงอะไร: อะไรต้องล็อก, เก็บนานเท่าไร, ใครเข้าถึงได้, และจัดการคำขอลบอย่างไร
ความรับผิดชอบของมนุษย์ (ไม่มีทางลัด)
ทำ security review, ตรวจพึ่งพาไลบรารี, และวางแผน incident response (การแจ้งเตือน, การเปลี่ยนคีย์ลับ, ขั้นตอน rollback) กำหนดเกณฑ์ "หยุดสายการผลิต" ก่อนปล่อย: ถ้ากฎการเข้าถึงไม่ชัดเจน, การจัดการข้อมูลละเอียดอ่อนยังไม่ผ่าน, หรือขาด auditability ให้หยุดการปล่อยจนกว่าจะชัดเจน
เวิร์กโฟลว์เชิงปฏิบัติ: ทำให้ AI มีประโยชน์โดยไม่เสียการควบคุม
AI มีคุณค่าที่สุดในงาน CRUD เมื่อคุณถือมันเป็นหุ้นส่วนร่างเร็ว — ไม่ใช่ผู้แต่งความจริง เป้าหมายง่าย ๆ: ย่นระยะจากไอเดียสู่โค้ดที่ใช้งานได้ พร้อมกับความรับผิดชอบต่อความถูกต้อง ความปลอดภัย และเจตนาของผลิตภัณฑ์
เครื่องมืออย่าง Koder.ai เหมาะกับโมเดลนี้: คุณอธิบายฟีเจอร์ CRUD ในแชท, สร้างร่างที่ทำงานได้ทั้ง UI และ API, แล้วทำซ้ำพร้อมการป้องกัน (เช่น โหมดวางแผน, snapshots, rollback) ในขณะที่มนุษย์ยังคงรับผิดชอบ permissions, migrations, และกฎธุรกิจ
1) Prompt ด้วยข้อจำกัดและเกณฑ์การยอมรับ
อย่าถามเพียง "user management CRUD" แต่ระบุการเปลี่ยนแปลงเฉพาะพร้อมขอบเขต
ใส่: framework/version, คอนเวนชันที่มีอยู่, ข้อจำกัดข้อมูล, พฤติกรรมข้อผิดพลาด, และคำว่า "เสร็จ" หมายถึงอะไร ตัวอย่างเกณฑ์การรับ: “ปฏิเสธซ้ำ คืน 409”, “soft-delete เท่านั้น”, “ต้องมี audit log”, “ห้าม N+1 queries”, “ต้องผ่านชุดทดสอบที่มีอยู่” สิ่งนี้ลดโค้ดที่เป็นไปได้แต่ผิด
2) สร้างทางเลือก แล้วเลือกอย่างตั้งใจ
ใช้ AI เสนอ 2–3 แนวทาง (เช่น “single table vs join table”, “REST vs RPC shape”) และขอให้อธิบายการแลกเปลี่ยน: ประสิทธิภาพ, ความซับซ้อน, ความเสี่ยงมิเกรชัน, โมเดลสิทธิ์ เลือกหนึ่งทางแล้วบันทึกเหตุผลใน ticket/PR เพื่ออนาคตไม่ลืมเหตุผล
3) เพิ่มเกตการตรวจโค้ดสำหรับส่วนเสี่ยง
กำหนดไฟล์บางประเภทให้ “ต้องมีการตรวจโดยมนุษย์เสมอ”:
- Permissions/auth: บทบาท, scopes, checks ระดับวัตถุ
- Migrations: ดีฟอลต์, backfill, ดัชนี, ความย้อนกลับ
- Data access: filters คิวรี, ขอบเขต tenant, pagination
- Logging/observability: การปกป้อง PII, correlation IDs, ระดับข้อผิดพลาด
ทำเป็นเช็คลิสต์ใน PR template หรือ /contributing
4) เก็บสเปกเป็นแหล่งความจริง
รักษาสเปกเล็ก ๆ ที่แก้ไขได้ (README ในโมดูล, ADR, หรือหน้ /docs) สำหรับเอนทิตีหลัก, กฎการตรวจสอบ, และการตัดสินเรื่องสิทธิ์ วางข้อความที่เกี่ยวข้องลงใน prompt เพื่อให้โค้ดที่สร้างสอดคล้อง แทนที่จะให้ AI "นึกขึ้นมาใหม่"
5) วัดผลนอกเหนือจาก "เผยแพร่แล้ว"
ติดตามผลลัพธ์: เวลาในการเปลี่ยน CRUD, อัตราบั๊ก (โดยเฉพาะข้อบกพร่องด้านสิทธิ์/การตรวจสอบ), ตั๋ว support, และเมตริกความสำเร็จของผู้ใช้ (การทำงานสำเร็จ, ลดวิธีแก้ด้วยมือ) ถ้าตัวชี้วัดเหล่านี้ไม่ดีขึ้น ให้ปรับ prompt, เพิ่มเกต, หรือลดขอบเขตการใช้ AI
คำถามที่พบบ่อย
What does “AI for CRUD apps” actually mean?
"AI for CRUD" โดยทั่วไปหมายถึงการใช้ AI เพื่อสร้าง ร่าง งานซ้ำ ๆ เช่น โมเดล, migrations, endpoints, ฟอร์ม และการทดสอบเริ่มต้น ตามคำอธิบายของคุณ.
มันเหมาะที่สุดในฐานะการเร่งงานสำหรับ boilerplate — ไม่ใช่คำรับประกันความถูกต้องหรือทดแทนการตัดสินใจด้านผลิตภัณฑ์.
Which CRUD tasks are the best fit for AI assistance?
ใช้ AI กับงานที่ มีแบบแผนและตรวจสอบได้ง่าย:
- สร้างโครง (scaffolding) models/routes/controllers
- ร่าง handlers สำหรับ list/detail/create/update/delete
- สร้างฟอร์มพื้นฐานและการตรวจสอบมาตรฐาน
- รีแฟคเตอร์เชิงกลไก (เปลี่ยนชื่อ, ดึงออกเป็น helper, ปรับรูปแบบ)
หลีกเลี่ยงการมอบหมายการตัดสินใจที่ต้องใช้วิจารณญาณ เช่น การกำหนดสิทธิ์ ความหมายของข้อมูล หรือ migrations ที่มีความเสี่ยง โดยไม่มีการทบทวน
What are the most common failure modes in AI-generated CRUD code?
โค้ดที่สร้างขึ้นสามารถ:
- อ่านความหมายของโดเมนผิด (เช่น “archived” vs “deleted”)
- เลือกค่าพื้นฐานที่ไม่ปลอดภัย (ขอบเขตการเข้าถึงกว้างเกินไป, ขาดการแยก tenant)
- พลาดกรณีขอบ (imports, concurrency, partial updates)
ถือว่าผลลัพธ์เป็นสิ่งที่ยังไม่เชื่อถือได้จนกว่าจะผ่านการทบทวนและการทดสอบ
How should I prompt AI to generate useful CRUD code drafts?
ให้ข้อจำกัดและเกณฑ์การยอมรับ ไม่ใช่แค่ชื่อฟีเจอร์:
- ระบุ framework/version และคอนเวนชันที่มีอยู่
- ข้อจำกัดข้อมูล (unique per tenant, กฎ soft-delete)
- พฤติกรรมข้อผิดพลาด (เช่น “return 409 on duplicates”)
- ขอบเขตด้านประสิทธิภาพ (ห้ามรายการไม่มีขอบเขต, ห้าม N+1)
- ข้อกำหนดด้านความปลอดภัย (authorization ระดับวัตถุ, logging แบบ audit)
ยิ่งมี “definition of done” ชัดเจน เทมเพลตที่ได้จาก AI ก็ยิ่งมีโอกาสถูกต้องมากขึ้น
Can AI safely design my data model and relationships?
AI สามารถเสนอ schema แบบคร่าว ๆ (ตาราง, ฟิลด์, enums, timestamps) แต่ไม่สามารถอนุมานได้อย่างเชื่อถือ:
- ความสัมพันธ์ที่ถูกต้อง (1:N vs N:M, ความจำเป็นของลิงก์)
- ขอบเขตความเป็นเจ้าของและ tenant
- พฤติกรรมเมื่อมีการลบ (restrict, cascade, soft delete, archive)
ใช้ AI ร่างตัวเลือก แล้วตรวจสอบกับเวิร์กโฟลว์จริงและสถานการณ์ล้มเหลวก่อนยอมรับ
What should I review before trusting an AI-generated migration?
migration อาจถูกต้องทางไวยากรณ์แต่ยังเสี่ยงได้ ก่อนรันบนข้อมูลจริง ให้ตรวจสอบ:
- จะล็อกตารางหรือเขียนซ้ำชุดข้อมูลขนาดใหญ่หรือไม่
- มีแถวเก่าที่ขัดกับข้อจำกัดใหม่หรือไม่
- ควรแยกเป็นขั้นตอน expand/migrate/contract หรือไม่
AI ช่วยร่าง migration และแผน rollout ได้ แต่ทีมคุณต้องเป็นเจ้าของการทบทวนความเสี่ยงและการดำเนินการ
How do I use AI for forms and validation without harming UX?
AI ดีในการแมปฟิลด์ schema เป็นอินพุตและสร้างตัวตรวจสอบพื้นฐาน (required, min/max, format) แต่สิ่งที่เสี่ยงคือความหมาย:
- อยาบังคับกฎที่เข้มงวดเกินความเป็นจริง (ชื่อ, เบอร์โทร, ที่อยู่มีความหลากหลาย)
- เก็บการตรวจสอบฝั่งเซิร์ฟเวอร์เป็นเกตจริงเสมอ
- ใช้ข้อจำกัดฐานข้อมูลสำหรับ invariants ที่ต้องไม่ผิดพลาดเด็ดขาด
ทบทวนแต่ละกฎและตัดสินใจว่ามันเป็นความสะดวก UX, สัญญา API, หรือข้อบังคับข้อมูล
What should I watch for in AI-generated API and query logic?
AI ร่าง endpoints, ฟิลเตอร์, pagination และ mapping ได้ไว แต่ให้ทบทวนจุดเสี่ยง:
- N+1 queries และดัชนีที่หายไป
- รายการไม่มีขอบเขตหรือการค้นหาที่หนักหน่วง
- ตัวกรอง/การจัดเรียงที่ไม่ปลอดภัย (อย่าแทรก input ของผู้ใช้ตรง ๆ ในคิวรี)
- การตัดสินใจเรื่อง pagination (offset vs cursor)
ตรวจสอบกับปริมาณข้อมูลที่คาดว่าจะเกิดจริงและงบประมาณด้านประสิทธิภาพ
How can AI help with testing without creating meaningless coverage?
AI สร้างเทสจำนวนมากได้ แต่คุณต้องเลือกเทสที่มีความหมาย ให้ความสำคัญกับ:
- เทสการถดถอย (regressions) สำหรับบั๊กที่เคยเกิด
- เทส permission (ใครอ่าน/เขียนได้หรือไม่ได้)
- กรณีล้มเหลว (input ไม่ถูกต้อง, ความสัมพันธ์ที่ขาดหาย)
- concurrency/idempotency (การส่งซ้ำ, การอัพเดตข้อมูลเก่า)
ถ้าเทสไม่จับความผิดพลาดที่อาจเกิดจริงในโปรดักชัน ให้ลบหรือเขียนใหม่
How should I handle auth, permissions, and safety when using AI?
AI ช่วยร่างกฎ RBAC/ABAC และ plumbing (middleware, policy stubs) ได้ แต่การอนุญาตถือเป็นพื้นที่มีความเสี่ยงสูง:
- ปกป้องทุกเส้นทางอ่าน (list, search, export, background jobs)
- ปกป้องทุกเส้นทางเขียน (create, update, delete, bulk, imports)
- บังคับกฎความเป็นเจ้าของฝั่งเซิร์ฟเวอร์ (อย่าเชื่อ hidden fields)
- บันทึกการกระทำสิทธิพิเศษพร้อม who/what/when (และถ้าเป็นไปได้ why)
มนุษย์ต้องกำหนด threat model, ค่าเริ่มต้น least-privilege, และความต้องการด้าน audit