

Nginx กับ HAProxy: เลือก Reverse Proxy ที่เหมาะสม
เปรียบเทียบ Nginx และ HAProxy ในฐานะ reverse proxy: ประสิทธิภาพ, การโหลดบาลานซ์, TLS, การสังเกตการณ์, ความปลอดภัย และรูปแบบการตั้งค่าที่นิยมเพื่อเลือกสิ่งที่เหมาะสมที่สุด
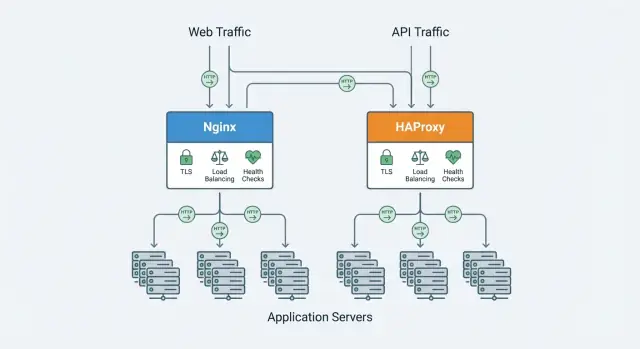
Reverse Proxy ทำอะไรให้แอปของคุณ
Reverse proxy คือเซิร์ฟเวอร์ที่อยู่ หน้าบ้าน ของแอปของคุณ รับคำขอจากไคลเอนต์ก่อน แล้วส่งต่อแต่ละคำขอไปยังบริการ backend ที่ถูกต้อง (เซิร์ฟเวอร์แอปของคุณ) จากนั้นส่งผลลัพธ์กลับให้ไคลเอนต์ ผู้ใช้คุยกับพร็อกซี; พร็อกซีคุยกับแอปของคุณ
Forward proxy ทำงานตรงข้าม: มันนั่งอยู่หน้าลูกค้า (เช่น ในเครือข่ายองค์กร) และส่งคำขอออกไปยังอินเทอร์เน็ต จุดประสงค์หลักคือการควบคุม กรอง หรือลบตัวตนของทราฟิกจากฝั่งลูกค้า
Load balancer มักถูกใช้งานเป็น reverse proxy แต่มีจุดมุ่งหมายเฉพาะคือ: กระจายทราฟิกไปยังอินสแตนซ์ backend หลายตัว ผลิตภัณฑ์หลายอย่าง (รวม Nginx และ HAProxy) ทั้งทำ reverse proxy และ load balancing จึงมักใช้สับสนกันได้
เป้าหมายทั่วไปที่ทีมมักใช้พร็อกซี
การนำไปใช้งานส่วนใหญ่เริ่มจากเหตุผลเหล่านี้อย่างน้อยหนึ่งข้อ:
- TLS/SSL termination: จัดการ HTTPS หนึ่งจุด ดูแลใบรับรองรวมศูนย์ และส่ง HTTP ภายในเมื่อเหมาะสม
- Routing: ส่งทราฟิกไปยังบริการต่างๆ ตาม hostname, path, headers หรือกฎอื่นๆ (เช่น
/apiไปยังบริการ API,/ไปยังเว็บแอป) - Buffering และการจัดการการเชื่อมต่อ: ปรับความลื่นไหลเมื่อไคลเอนต์ช้าหรือ upstream ช้า ลด overhead ต่อการเชื่อมต่อบนเซิร์ฟเวอร์แอป และเพิ่มความน่าเชื่อถือที่รับรู้ได้
- การควบคุมการป้องกัน: บังคับใช้ขีดจำกัดคำขอ การกรองพื้นฐาน และค่าเริ่มต้นที่ปลอดภัยก่อนคำขอจะถึงแอปของคุณ
มันอยู่หน้าบ้านแอปอย่างไร
Reverse proxy มักยืนหน้า เว็บไซต์, API, และ ไมโครเซอร์วิสส์ — ทั้งที่ขอบเครือข่าย (สาธารณะ) หรือภายในระหว่างบริการ ในสแต็กสมัยใหม่ พวกมันยังถูกใช้เป็นส่วนประกอบของ ingress gateway, blue/green deploys, และการตั้งค่า high-availability
คู่มือนี้จะช่วยตัดสินใจอะไรบ้าง
Nginx และ HAProxy ทับซ้อนกัน แต่ต่างกันในรายละเอียด ต่อไปนี้เราจะเปรียบเทียบปัจจัยการตัดสินใจ เช่น ประสิทธิภาพเมื่อมีการเชื่อมต่อจำนวนมาก, load balancing และ health checks, การรองรับโปรโตคอล (HTTP/2, TCP), ฟีเจอร์ TLS, การสังเกตการณ์ (observability), และ การตั้งค่าและปฏิบัติการประจำวัน
ภาพรวม Nginx: จุดแข็งและกรณีใช้งานทั่วไป
Nginx ถูกใช้แพร่หลายทั้งเป็น เว็บเซิร์ฟเวอร์ และ reverse proxy หลายทีมเริ่มด้วยมันเพื่อให้บริการเว็บไซต์สาธารณะ แล้วขยายบทบาทไปอยู่หน้าบริการแอป — จัดการ TLS, กำหนดเส้นทางทราฟิก, และบรรเทาช่วงพีค
ทำไมคนชอบใช้ Nginx ที่ขอบเครือข่าย
Nginx เหมาะเมื่อทราฟิกของคุณเป็น HTTP(S) เป็นหลัก และคุณต้องการ “ประตูหน้า” เดียวที่ทำได้หลากหลาย มันเด่นในการ:
- ให้บริการ static assets (ภาพ, CSS/JS) อย่างมีประสิทธิภาพ
- ทำหน้าที่เป็น HTTP reverse proxy พร้อม การกำหนดเส้นทางตาม path/host ที่ตรงไปตรงมา
- Caching เพื่อลดโหลดบน upstream apps
- เพิ่มหรือทำให้ header เป็นมาตรฐาน (เช่น
X-Forwarded-For, header ด้านความปลอดภัย)
เพราะมันทั้งให้บริการเนื้อหาและพร็อกซีไปยังแอป Nginx จึงเป็นตัวเลือกทั่วไปสำหรับการตั้งค่าเล็กถึงกลางที่ต้องการชิ้นส่วนน้อยลง
โมดูลและฟีเจอร์ที่ทีมพึ่งพา
ความสามารถยอดนิยมรวมถึง:
- TLS termination และเวิร์กโฟลว์การจัดการใบรับรอง (มักมีการอัตโนมัติรอบการรีโหลด)
- Compression (gzip/brotli ขึ้นกับการคอมไพล์) เพื่อลดแบนด์วิดท์
- Rate limiting และการควบคุมคำขอพื้นฐานเพื่อป้องกันไคลเอนต์ดัง
- Rewrites และ redirects สำหรับทำความสะอาด URL และย้ายระบบเก่า
- ฟีเจอร์เสริมเช่น WebSocket proxying สำหรับแอปเรียลไทม์
กรณี “front door” ทั่วไป
Nginx มักถูกเลือกเมื่อคุณต้องการจุดเข้าหนึ่งเดียวสำหรับ:
- เว็บไซต์การตลาดพร้อม API (static + proxy)
- Load balancing แบบง่ายข้ามไม่กี่อินสแตนซ์
- Caching หน้าบริการช้า (เช่น CMS หรือ REST service)
- ทำหน้าที่เป็น gateway สำหรับหลายบริการภายใต้ hostnames ต่างกัน
ถ้าความสำคัญของคุณคือการจัดการ HTTP อย่างครบถ้วนและคุณชอบแนวคิดในการรวมการให้บริการเว็บกับ reverse proxy Nginx มักเป็นค่าเริ่มต้นที่ดี
ภาพรวม HAProxy: จุดแข็งและกรณีใช้งานทั่วไป
HAProxy (High Availability Proxy) มักใช้เป็น reverse proxy และ load balancer ที่อยู่หน้าบริการแอป มันรับทราฟิกเข้ามา ใช้กฎ routing/ทราฟิก แล้วส่งคำขอไปยัง backend ที่ healthy — มักทำให้เวลาตอบกลับคงที่แม้ภายใต้ concurrency หนัก
HAProxy มักถูกใช้งานเพื่ออะไร
ทีมมักติดตั้ง HAProxy เพื่อ จัดการทราฟิก: กระจายการร้องขอไปยังเซิร์ฟเวอร์หลายเครื่อง ทำให้บริการยังใช้งานได้เมื่อล้มเหลว และบรรเทาช่วงพีค มันเป็นตัวเลือกบ่อยที่ขอบ (north–south) และภายใน (east–west) โดยเฉพาะเมื่อต้องการพฤติกรรมที่คาดเดาได้และการควบคุมการเชื่อมต่อ
จุดแข็งหลัก: การเชื่อมต่อ, load balancing, health checks
HAProxy เด่นเรื่องการจัดการการเชื่อมต่อพร้อมกันจำนวนมาก สิ่งนี้สำคัญเมื่อคุณมีไคลเอนต์จำนวนมากเชื่อมต่อพร้อมกัน (API ที่มีคนใช้เยอะ การเชื่อมต่อยาว เช่น chat) และต้องการให้พร็อกซีตอบสนองได้
ความสามารถในการโหลดบาลานซ์เป็นเหตุผลหลักที่คนเลือก มันรองรับอัลกอริทึมและกลยุทธ์การ routing ที่หลากหลาย ช่วยให้คุณ:
- ป้องกันไม่ให้เซิร์ฟเวอร์ “ร้อน” โดน overload
- ย้ายทราฟิกทีละน้อยในระหว่าง rollout
- เลือกอินสแตนซ์ที่เร็วหรือมีโหลดน้อยกว่าเมื่อจำเป็น
Health checks เป็นอีกจุดแข็ง HAProxy สามารถตรวจสอบ backend แบบ active ได้และนำอินสแตนซ์ที่ไม่ดีออกจากวงจรโดยอัตโนมัติ แล้วใส่กลับเมื่อมันฟื้น คืนค่าเป็นเวลาที่ลด downtime และป้องกันการ deploy ที่ “ครึ่งเสีย” มีผลกระทบต่อผู้ใช้ทั้งหมด
Layer 4 vs Layer 7: หมายความว่าอะไรในทางปฏิบัติ
HAProxy สามารถทำงานที่ Layer 4 (TCP) และ Layer 7 (HTTP)
- Layer 4 (TCP) มุ่งเน้นการส่งต่อการเชื่อมต่อแบบ raw เหมาะกับโปรโตคอลที่ไม่ต้องตรวจ HTTP รายละเอียด — เช่น โปรโตคอล TCP ทั่วไป, โปรดักซ์ฐานข้อมูล, หรือต้องการ overhead ต่ำสุด
- Layer 7 (HTTP) เข้าใจความหมายของ HTTP ทำให้ใช้ฟีเจอร์อย่างการ routing ตาม header, เงื่อนไข path, และการควบคุมทราฟิกที่ละเอียดขึ้น
ความแตกต่างเชิงปฏิบัติ: L4 โดยทั่วไปเรียบง่ายและเร็วสำหรับการส่งผ่าน TCP ในขณะที่ L7 ให้การ routing และตรรกะคำขอที่ทรงพลังเมื่อคุณต้องการ
เมื่อเลือก HAProxy
HAProxy มักถูกเลือกเมื่อเป้าหมายหลักคือ โหลดบาลานซ์ที่เชื่อถือได้และประสิทธิภาพสูงพร้อมการตรวจสุขภาพที่แน่นอน — เช่น การกระจายทราฟิก API ข้ามหลายเซิร์ฟเวอร์, จัดการ failover ระหว่าง availability zone, หรือทำหน้าที่หน้าเซอร์วิสที่ปริมาณการเชื่อมต่อและพฤติกรรมทราฟิกมีความสำคัญมากกว่าฟีเจอร์เว็บเซิร์ฟเวอร์ขั้นสูง
พื้นฐานด้านประสิทธิภาพ: หน่วงเวลา, อัตราส่งข้อมูล, และการเชื่อมต่อ
การเปรียบเทียบประสิทธิภาพมักผิดพลาดเพราะมองตัวเลขเดียว (เช่น “max RPS”) แล้วละเลยสิ่งที่ผู้ใช้รู้สึก
Throughput vs latency vs tail latency
- Throughput คือปริมาณงานที่ส่งผ่านได้ (requests/second หรือ bytes/second)
- Latency คือเวลาที่คำขอใช้
- Tail latency (p95/p99) คือจุดที่ปัญหาแท้จริงปรากฏ: แม้ค่าเฉลี่ยจะโอเค แต่ 1–5% ที่ช้าที่สุดสามารถทำให้เกิด timeout, retry, และ UX ที่แย่ได้
พร็อกซีอาจเพิ่ม throughput แต่ทำให้ tail latency แย่ขึ้นถ้ามันต่อคิวงานมากเกินไปภายใต้ภาระ
รูปแบบการเชื่อมต่อสำคัญ
คิดถึง “รูปทรง” ของแอปของคุณ:
- คำขอสั้นจำนวนมาก (ทราฟิกเว็บทั่วไป): ความมีประสิทธิภาพในการยอมรับการเชื่อมต่อ, TLS handshake, และการแยกวิเคราะห์คำขอมีความสำคัญ
- การเชื่อมต่อยาวจำนวนน้อย (WebSockets, streaming, gRPC, TCP เหมือนฐานข้อมูล): ความเสถียรและการใช้ทรัพยากรที่คาดเดาได้ต่อการเชื่อมต่อสำคัญกว่าจำนวน RPS สูงสุด
ถ้าคุณ benchmark ด้วยรูปแบบหนึ่งแต่ deploy อีกแบบ ผลลัพธ์จะไม่สามารถถ่ายโอนได้
Buffering: มิตรหรือศัตรู
Buffering สามารถ ช่วย เมื่อไคลเอนต์ช้าหรือมีบัสต์ เพราะพร็อกซีอ่านคำขอ/ตอบทั้งหมดแล้วป้อนให้แอปอย่างสม่ำเสมอ
Buffering สามารถ ทำร้าย เมื่อแอปของคุณต้องการสตรีม (SSE, ดาวน์โหลดใหญ่, API เรียลไทม์) เพราะการบัฟเฟอร์เพิ่มแรงกดดันหน่วยความจำและอาจเพิ่ม tail latency
เคล็ดลับการเบนช์มาร์กเชิงปฏิบัติ
วัดมากกว่า “max RPS”:
- RPS/throughput, p50/p95/p99 latency, และ อัตราความผิดพลาด (timeouts, 502/503)
- ทดสอบ โหลดคงที่ และ สไปก์ (บัสต์สั้นมักเผยพฤติกรรมการต่อคิว)
- ใช้การตั้งค่า keep-alive/TLS ที่สมจริง และบันทึก CPU, memory, และการเชื่อมต่อเปิดค้าง
ถ้า p95 เพิ่มขึ้นอย่างรวดเร็วก่อนเกิดข้อผิดพลาด คุณกำลังเห็นสัญญาณเตือนว่าใกล้เต็ม ไม่ใช่ “พื้นที่เหลือฟรี”
การโหลดบาลานซ์และการตรวจสุขภาพ (Health Checks)
ทั้ง Nginx และ HAProxy สามารถอยู่หน้าหลายอินสแตนซ์แอปและกระจายทราฟิก แต่ต่างกันในเชิงลึกของฟีเจอร์ที่มากับตัว
อัลกอริทึมการโหลดบาลานซ์
Round-robin เป็นค่าเริ่มต้นที่ “พอใช้ได้” เมื่อ backend คล้ายกัน มันเรียบง่าย คาดเดาได้ และเหมาะกับแอป stateless
Least connections มีประโยชน์เมื่อคำขอมีระยะเวลาต่างกัน (ดาวน์โหลด, การเรียก API ยาว, การเชื่อมต่อยาว) มันช่วยกันไม่ให้เซิร์ฟเวอร์ช้าถูกโจมตีด้วยโหลดเพราะจะให้ความสำคัญกับ backend ที่มีคำขอ active น้อยกว่า
Weighted balancing (round-robin แบบมีน้ำหนัก หรือ weighted least connections) เหมาะเมื่อเซิร์ฟเวอร์ไม่เหมือนกัน — ผสม node เก่า/ใหม่ ขนาดอินสแตนซ์ต่างกัน หรือต้องการย้ายทราฟิกทีละน้อย
โดยทั่วไป HAProxy ให้ตัวเลือกอัลกอริทึมมากกว่าและการควบคุมละเอียดกว่า ที่ Layer 4/7 ขณะที่ Nginx ครอบคลุมกรณีทั่วไปอย่างชัดเจน (และสามารถขยายได้ขึ้นกับ edition/module)
Session persistence (stickiness)
Stickiness ทำให้ผู้ใช้ยังคงถูกส่งไปยัง backend เดิมข้ามคำขอ
- Cookie-based persistence เหมาะที่สุดสำหรับเว็บแอป: ชัดเจน ทำงานข้าม NAT และอนุญาตให้ failover ควบคุมได้ถ้า backend หายไป
- Source IP persistence เปิดใช้งานง่าย แต่ไม่เป็นธรรม (ผู้ใช้หลายคนหลัง NAT อาจไปที่ backend เดียว) และอาจพังถ้า visibility ของ IP เปลี่ยน (CDN, พร็อกซี)
ใช้ stickiness เฉพาะเมื่อจำเป็นเท่านั้น (เช่น session ฝั่งเซิร์ฟเวอร์แบบเก่า) บริการ stateless มักสเกลและกู้คืนได้ดีกว่า
Health checks: active vs passive
Active health checks ตรวจสอบ backend เป็นระยะ (endpoint HTTP, การเชื่อมต่อ TCP, สถานะที่คาดหวัง) พวกมันจับความล้มเหลวแม้เมื่อทราฟิกต่ำ
Passive health checks ตอบสนองต่อทราฟิกจริง: timeout, error connection, หรือตอบกลับไม่ดีจะทำให้เครื่องถูกมาร์คว่าไม่ดี พวกมันเบา แต่ตรวจจับปัญหาได้นานกว่า
HAProxy เป็นที่รู้จักเรื่อง การควบคุม health-check และ failure-handling ที่ละเอียด (thresholds, rise/fall counts, การตรวจสอบแบบละเอียด) Nginx ก็รองรับการตรวจสอบที่แข็งแรงเช่นกัน ขึ้นกับการคอมไพล์และ edition
การ deploy แบบไม่มี downtime: draining และ retries
สำหรับ rolling deploys ควรมองหา:
- Connection draining: หยุดส่งคำขอใหม่ไปยัง backend แต่ให้คำขอที่กำลังประมวลผลเสร็จ
- Retries และ redispatch: ถ้า backend ล้มกลางคำขอ ให้ลองใหม่อย่างปลอดภัย (เฉพาะคำขอที่ idempotent) หรืส่งคำขอไปยังเซิร์ฟเวอร์ healthy ตัวอื่น
ไม่ว่าจะเลือกอะไร ให้จับคู่ draining กับ timeout สั้นชัดเจนและ endpoint “ready/unready” เพื่อให้ทราฟิกย้ายอย่างราบรื่นระหว่างการ deploy
โปรโตคอลและ TLS: HTTP, HTTP/2, และ TCP Proxying
Reverse proxy อยู่ที่ขอบระบบ ดังนั้นการเลือกโปรโตคอลและ TLS ส่งผลต่อทุกอย่างตั้งแต่ประสิทธิภาพเบราว์เซอร์ถึงวิธีที่บริการสื่อสารกัน
การยุติ TLS และการจัดการใบรับรอง
ทั้ง Nginx และ HAProxy สามารถ “terminate” TLS: รับการเชื่อมต่อเข้ารหัสจากลูกค้า ถอดรหัส แล้วส่งคำขอไปยังแอปเป็น HTTP หรือเข้ารหัสใหม่เป็น TLS
ความจริงในทางปฏิบัติคือการจัดการใบรับรอง คุณต้องมีแผนสำหรับ:
- การขอและต่ออายุใบรับรอง (มักผ่าน ACME/Let’s Encrypt)
- การเก็บกุญแจส่วนตัวอย่างปลอดภัยและจำกัดการเข้าถึง
- การรีโหลดคอนฟิกโดยไม่ตัดการเชื่อมต่อ
Nginx มักถูกเลือกเมื่อต้องการยุติ TLS พร้อมฟีเจอร์เว็บเซิร์ฟเวอร์ (ไฟล์สแตติก, รีไดเรกต์) HAProxy มักถูกเลือกเมื่อ TLS เป็นส่วนหนึ่งของชั้นการจัดการทราฟิก (โหลดบาลานซ์และการจัดการการเชื่อมต่อ)
HTTP/2: ประสิทธิภาพและความเข้ากันได้
HTTP/2 ช่วยลดเวลาโหลดเพจโดย multiplexing คำขอหลายรายการผ่านการเชื่อมต่อเดียว ทั้งสองเครื่องมือรองรับ HTTP/2 ฝั่งลูกค้า
ข้อพิจารณาหลัก:
- ความเข้ากันได้ของไคลเอนต์: เบราว์เซอร์สมัยใหม่ส่วนใหญ่รองรับ HTTP/2 แต่ไคลเอนต์เก่าหรือเครื่องมืออัตโนมัติบางอย่างอาจไม่รองรับ
- การรองรับ backend: คุณสามารถ terminate HTTP/2 ที่พร็อกซีแล้วคุยกับ upstream เป็น HTTP/1.1 ซึ่งเป็นแนวทางที่พบบ่อยและง่ายกว่า
เมื่อการพร็อกซี TCP สำคัญ
ถ้าคุณต้องการ route ทราฟิกที่ไม่ใช่ HTTP (ฐานข้อมูล, SMTP, Redis, โปรโตคอลกำหนดเอง) คุณต้องการการพร็อกซี TCP มากกว่าการ routing HTTP HAProxy ถูกใช้กันแพร่หลายสำหรับ TCP load balancing ที่มีประสิทธิภาพสูงและการควบคุมการเชื่อมต่อที่ละเอียด Nginx ก็สามารถพร็อกซี TCP ได้เช่นกัน (ผ่านความสามารถ stream) ซึ่งเพียงพอสำหรับการตั้งค่า pass-through แบบตรงไปตรงมาบางอย่าง
Mutual TLS (mTLS)
mTLS ยืนยันทั้งสองฝ่าย: ไคลเอนต์ต้องแสดงใบรับรอง ไม่ใช่แค่เซิร์ฟเวอร์ เหมาะกับการสื่อสารระหว่างบริการ การผสานกับพันธมิตร หรือการออกแบบ zero-trust ทั้งสองพร็อกซีสามารถบังคับการตรวจสอบใบรับรองของไคลเอนต์ที่ขอบ และหลายทีมยังใช้ mTLS ภายในระหว่างพร็อกซีและ upstream เพื่อย่นระยะความไว้ใจของเครือข่าย
การสังเกตการณ์: การล็อก, เมตริก, และการดีบัก
พร็อกซีอยู่ตรงกลางทุกคำขอ จึงมักเป็นที่ดีที่สุดในการตอบคำถามว่า “เกิดอะไรขึ้น?” การสังเกตการณ์ที่ดีหมายถึงล็อกที่สม่ำเสมอ เมตริกสัญญาณชัดเจนไม่กี่ชนิด และวิธีการซ้ำได้ในการดีบัก timeouts และข้อผิดพลาด gateway
ล็อกที่ต้องมี: access, error, และ upstream timing
อย่างน้อย ควรเปิดใช้งาน access logs และ error logs ในการผลิต สำหรับ access logs ให้รวมเวลาตอบ upstream เพื่อบอกได้ว่าส่วนช้าเกิดจากพร็อกซีหรือแอป
ใน Nginx ฟิลด์ทั่วไปคือเวลาคำขอและเวลา upstream (เช่น $request_time, $upstream_response_time, $upstream_status) ใน HAProxy ให้เปิด HTTP log mode และจับฟิลด์เวลา (queue/connect/response times) เพื่อแยกระหว่าง “รอคิวช่อง backend” กับ “backend ช้า”
เก็บล็อกในรูปแบบมีโครงสร้าง (JSON ถ้าเป็นไปได้) และเพิ่ม request ID (จาก header เข้ามาหรือสร้างใหม่) เพื่อเชื่อมล็อกพร็อกซีและแอปเข้าด้วยกัน
เมตริกที่ควรส่งออก
ไม่ว่าจะ scrape Prometheus หรือส่งเมตริกที่อื่น ให้ส่งชุดเดียวกัน:
- จำนวนคำขอและรหัสตอบกลับ (2xx/4xx/5xx)
- เคาน์เตอร์ข้อผิดพลาด (retries, failed health checks, 502/504)
- เวลาแฝง (p50/p95/p99; แยก proxy vs upstream จะดี)
- การเชื่อมต่อ (active, queued, rejected)
Nginx มักใช้ stub status endpoint หรือตัวส่งออก Prometheus; HAProxy มี stats endpoint ในตัวที่ exporter หลายตัวอ่านได้
endpoints สุขภาพและ readiness
เปิดเผย /health (process ทำงาน) และ /ready (เข้าถึง dependency ได้) ใช้ทั้งสองใน automation: health checks ของ load balancer, การ deploy, และการ auto-scaling
การดีบัก timeouts, resets, 502/504
- 502: backend ปฏิเสธ/ปิดการเชื่อมต่อ, ปัญหา DNS, หรือความไม่ตรงกันของโปรโตคอล
- 504: พร็อกซีหมดเวลารอ backend
- Resets/timeouts: ตรวจสอบการตั้งค่า keep-alive, saturation ของ backend, และความยาวคิว
เมื่อตรวจสอบ ให้เทียบเวลาของพร็อกซี (queue/connect) กับเวลา upstream ถ้า queue/connect สูง ให้เพิ่มความสามารถหรือปรับ load balancing; ถ้าเวลา upstream สูง ให้มุ่งแก้ที่แอปหรือฐานข้อมูล
การตั้งค่าและการปฏิบัติการประจำวัน
การรันพร็อกซีไม่ใช่แค่เรื่อง throughput สูงสุด แต่ยังเกี่ยวกับทีมของคุณสามารถทำการเปลี่ยนแปลงอย่างปลอดภัยได้เร็วแค่ไหน ไม่ว่าจะตอน 14:00 หรือ 02:00
รูปแบบคอนฟิกและการเรียนรู้
คอนฟิก Nginx เป็นแบบ directive และมีลำดับชั้น อ่านเหมือน “บล็อกซ้อนบล็อก” (http → server → location) ซึ่งหลายคนพบว่าง่ายเมื่อต้องคิดเป็นไซต์และเส้นทาง
คอนฟิก HAProxy เป็นแนว “pipeline”: นิยาม frontends (สิ่งที่รับ), backends (ส่งไปที่ไหน), แล้วผูกกฎ (ACLs) เพื่อเชื่อมทั้งสอง มันอาจรู้สึกชัดเจนและคาดเดาได้เมื่อเข้าใจโมเดล โดยเฉพาะสำหรับตรรกะการ routing
การรีโหลดและการจัดการการเปลี่ยนแปลง
Nginx มักรีโหลดคอนฟิกโดยเริ่ม worker ใหม่และ drain worker เก่าอย่างนุ่มนวล เหมาะกับการอัปเดตเส้นทางและการต่ออายุใบรับรองบ่อยๆ
HAProxy ก็สามารถรีโหลดแบบ seamless ได้ แต่ทีมมักปฏิบัติต่อมันเหมือน “อุปกรณ์”: ควบคุมการเปลี่ยนแปลงเข้มงวด เวอร์ชันคอนฟิกชัดเจน และประสานงานการรีโหลดอย่างระมัดระวัง
การ validate, เท็มเพลต, และการไม่ทำซ้ำ (DRY)
ทั้งสองรองรับการทดสอบคอนฟิกก่อนรีโหลด (จำเป็นสำหรับ CI/CD) ในทางปฏิบัติ คุณมักจะทำให้คอนฟิก DRY โดยการสร้างมัน:
- ใช้เท็มเพลต (Helm, Ansible, Terraform, หรือเครื่องมือภายใน)
- เก็บสแนิปเพ็ตแชร์สำหรับ logging, headers, timeouts, และ security defaults
นิสัยการปฏิบัติที่สำคัญ: จัดการคอนฟิกพร็อกซีเป็นโค้ด — รีวิว ทดสอบ และปรับใช้เหมือนการเปลี่ยนแปลงของแอป
การปฏิบัติการในระดับใหญ่: แอป เส้นทาง และใบรับรองจำนวนมาก
เมื่อจำนวนบริการเพิ่มขึ้น ปัญหาที่แท้จริงคือการแพร่ของใบรับรองและการกำหนดเส้นทาง วางแผนสำหรับ:
- การตั้งชื่อและความเป็นเจ้าของมาตรฐาน (ใครเป็นเจ้าของ hostname ไหน)
- การออก/หมุนเวียนใบรับรองอัตโนมัติ
- ข้อตกลงที่ชัดเจนสำหรับ timeout และ retry ต่อแอป
ถ้าคาดว่าจะมีหลายร้อยโฮสต์ ให้พิจารณาเซ็นทรัลไลส์แพตเทิร์นและสร้างคอนฟิกจากเมตาดาต้าบริการ แทนการแก้ไขไฟล์ด้วยมือ
Koder.ai เข้ามาอยู่ในเวิร์กโฟลว์อย่างไร
ถ้าคุณกำลังสร้างและ iterate หลายบริการ พร็อกซีเป็นเพียงส่วนหนึ่งของพายพาธการส่งมอบ — คุณยังต้องการโครงสร้างแอปที่ทำซ้ำได้ ความสอดคล้องของสภาพแวดล้อม และการโรลเอาท์ที่ปลอดภัย
Koder.ai ช่วยทีมให้เร็วขึ้นจาก “ไอเดีย” ไปสู่บริการที่รันได้ โดยสร้าง React เว็บแอป, backend Go + PostgreSQL, และแอปมือถือ Flutter ผ่านเวิร์กโฟลว์แบบแชท พร้อมรองรับ การส่งออกซอร์สโค้ด, การปรับใช้/โฮสติ้ง, โดเมนที่กำหนดเอง, และ snapshot พร้อม rollback ในทางปฏิบัติ นั่นหมายความว่าคุณสามารถโปรโตไทป์ API + เว็บ frontend, ปรับใช้มัน แล้วตัดสินใจว่าจะใช้ Nginx หรือ HAProxy เป็นประตูหน้าตามรูปแบบทราฟิกจริง แทนการเดา
คำถามที่พบบ่อย
What’s the difference between a reverse proxy and a forward proxy?
พร็อกซีย้อนกลับนั่งอยู่หน้าระบบของคุณ: ลูกค้าติดต่อกับพร็อกซี แล้วพร็อกซีจะส่งคำขอไปยังบริการ backend ที่ถูกต้องและส่งผลลัพธ์กลับให้ลูกค้า
พร็อกซีไปข้างหน้า (forward proxy) นั่งอยู่หน้าลูกค้าและควบคุมการเข้าถึงอินเทอร์เน็ตของพวกเขา (พบบ่อยในเครือข่ายองค์กร)
Is a load balancer the same thing as a reverse proxy?
ตัวโหลดบาลานเซอร์เน้นที่การแจกจ่ายทราฟิกไปยังอินสแตนซ์ backend หลายตัว หลายตัวโหลดบาลานเซอร์ถูกใช้งานเป็นพร็อกซีย้อนกลับ จึงทำให้คำสองคำนี้ทับซ้อนกันได้
ในทางปฏิบัติ คุณมักจะใช้เครื่องมือหนึ่งตัว (เช่น Nginx หรือ HAProxy) เพื่อทำทั้งสองอย่าง: ทำหน้าที่เป็นพร็อกซีย้อนกลับและเป็นโหลดบาลานเซอร์
Where should a reverse proxy sit in an architecture?
วางพร็อกซีที่จุดควบคุมเดียวที่คุณต้องการ:
- ขอบระบบ (อินเทอร์เน็ตสาธารณะ → ระบบของคุณ): การยุติ TLS, การกำหนดเส้นทาง, การป้องกันพื้นฐาน, การล็อกที่สอดคล้องกัน
- ภายใน (บริการ → บริการ): การปรับรูปแบบทราฟิก ควบคุมการเชื่อมต่อ และการโรลเอาท์ที่ปลอดภัย
หลักการคืออย่าให้ไคลเอนต์เข้าถึง backend โดยตรง เพื่อให้พร็อกซีเป็นจุดควบคุมสำหรับนโยบายและการมองเห็น
What does “TLS/SSL termination” mean, and why is it useful?
การยุติ TLS หมายถึงพร็อกซีจัดการ HTTPS: ยอมรับการเชื่อมต่อที่เข้ารหัสจากลูกค้า ถอดรหัส แล้วส่งทราฟิกไปยัง upstream เป็น HTTP หรือเข้ารหัสใหม่เป็น TLS
ทางปฏิบัติ คุณต้องวางแผนเรื่อง:
- การออก/ต่ออายุใบรับรองอัตโนมัติ (มักใช้ ACME/Let’s Encrypt)
- การเก็บคีย์ส่วนตัวอย่างปลอดภัย
- การรีโหลดคอนฟิกโดยไม่ตัดการเชื่อมต่อที่ใช้งานอยู่
When is Nginx usually the better choice?
เลือก Nginx เมื่อพร็อกซีของคุณเป็น “ประตูหน้า” ของเว็บ:
- ให้บริการไฟล์สแตติกได้อย่างมีประสิทธิภาพ
- Caching (รวมถึง micro-caching) เพื่อลดโหลดบน backend
- การกำหนดเส้นทางแบบง่าย (host/path), รีไดเรกต์, และการปรับ header
- การตั้งค่าที่สะดวกสำหรับ TLS และฟีเจอร์ฝั่ง HTTP
When is HAProxy usually the better choice?
เลือก HAProxy เมื่อการจัดการทราฟิกและความคาดเดาได้ภายใต้ภาระเป็นสิ่งสำคัญ:
- รองรับการเชื่อมต่อพร้อมกันจำนวนมากอย่างมีประสิทธิภาพ
- การควบคุมการโหลดบาลานซ์ที่ละเอียดและตัวเลือกหลายแบบ
- การตรวจสุขภาพ (health checks) ที่แข็งแรงและการจัดการล้มเหลว
- การพร็อกซีระดับ Layer 4 (TCP) เป็นกรณีการใช้งานสำคัญ
How do I choose between round-robin, least-connections, and weighted balancing?
ใช้ round-robin เมื่อ backend คล้ายกันและค่าใช้จ่ายต่อคำขอใกล้เคียงกัน
ใช้ least-connections เมื่อระยะเวลาของคำขอแตกต่างกัน (ดาวน์โหลด ไคลเอนต์ยาว) เพื่อไม่ให้เครื่องช้าโดนโหลดหนัก
ใช้ weighted เมื่อ backend แตกต่างกัน (ขนาดอินสแตนซ์ต่างกัน หรือย้ายทีละน้อย) เพื่อกระจายทราฟิกตามน้ำหนักที่ตั้ง
Do I need session persistence (sticky sessions), and which type is best?
การยึดเซสชัน (stickiness) ทำให้ผู้ใช้ถูกส่งไปยัง backend เดิมในหลายคำขอ
- แนะนำ cookie-based สำหรับเว็บแอป (ชัดเจนและทำงานได้ดีข้าม NAT)
- ระวัง source-IP เพราะผู้ใช้หลายคนอาจอยู่หลัง NAT เดียวกันและ CDN/พร็อกซีอาจเปลี่ยน IP
ถ้าเป็นไปได้ หลีกเลี่ยง stickiness: บริการแบบ stateless มักสเกลและกู้คืนได้ดีกว่า
How can proxy buffering affect latency and streaming workloads?
การบัฟเฟอร์ช่วยได้เมื่อไคลเอนต์ช้าหรือเกิดบัสต์ เพราะพร็อกซีอ่านคำขอ/ตอบให้ครบแล้วส่งต่อให้แอปอย่างสม่ำเสมอ
มันจะเป็นปัญหาเมื่อคุณต้องการพฤติกรรมแบบ streaming (SSE, WebSockets, การดาวน์โหลดใหญ่) เพราะการบัฟเฟอร์เพิ่มแรงกดดันหน่วยความจำและอาจทำให้ tail latency แย่ลง
ถ้าแอปของคุณเน้นสตรีม ควรทดสอบและจูนการบัฟเฟอร์อย่างชัดเจน
How should I troubleshoot 502/504 errors and timeouts?
เริ่มจากการแยกระยะเวลารอของพร็อกซีออกจากการตอบของ backend โดยใช้ล็อกและเมตริก
ความหมายทั่วไป:
- 502: backend ปฏิเสธ/ปิดการเชื่อมต่อ, ปัญหา DNS, หรือตรงกันข้ามของโปรโตคอล
- 504: พร็อกซีหมดเวลารอ backend
สัญญาณที่ใช้งานได้: เวลาคิว/การเชื่อมต่อ (proxy) เทียบกับเวลาตอบ upstream
แก้ไขโดยปรับ timeout, เพิ่มความสามารถของ backend, หรือตั้งค่า health checks/readiness ให้ถูกต้อง