

วิธีสร้างเว็บแอปสำหรับข้อค้นพบจากการสัมภาษณ์ลูกค้า
วางแผน ออกแบบ และปล่อยเว็บแอปที่เก็บการสัมภาษณ์ ติดแท็กข้อค้นพบ และแชร์รายงานกับทีมทีละขั้นตอน
สิ่งที่คุณกำลังสร้างและทำไมมันสำคัญ
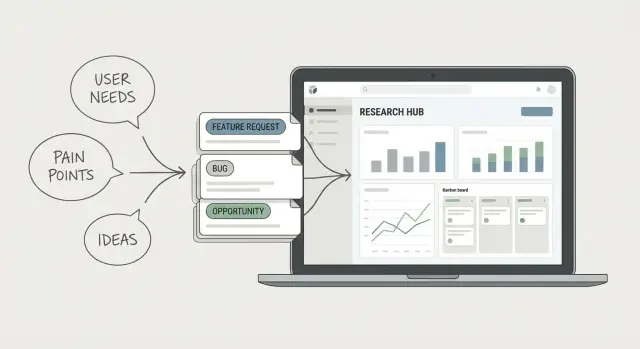
คุณกำลังสร้างเว็บแอปที่เปลี่ยนวัสดุจากการสัมภาษณ์ลูกค้าที่รกเข้ากับแหล่งข้อมูลที่แชร์ได้และค้นหาได้เป็นแหล่งความจริงเดียวกัน.
ทีมส่วนใหญ่ก็ ทำ การสัมภาษณ์ลูกค้าอยู่แล้ว—แต่ผลลัพธ์กระจัดกระจายอยู่ในเอกสาร สเปรดชีต สไลด์ บันทึก Zoom และสมุดโน้ตส่วนตัว สัปดาห์ต่อมา คำพูดที่คุณต้องการอาจหายาก บริบทขาดหาย และทุกโปรเจกต์ใหม่ก็กลับไป "ค้นพบ" ข้อค้นพบเดิมซ้ำแล้วซ้ำเล่า.
ปัญหาที่มันแก้
เครื่องมือนี้แก้ความล้มเหลวสามอย่างที่พบบ่อย:
- โน้ตกระจัดกระจาย: ข้อมูลอยู่หลายที่เกินไป ไม่มีโครงสร้างที่สม่ำเสมอ
- ข้อค้นพบหายาก: งานวิจัยดีๆ ก็ยังสูญหายเพราะค้นหาไม่ได้หรือใช้ซ้ำไม่ได้
- การรายงานไม่สม่ำเสมอ: ทีมต่างกันสรุปการสัมภาษณ์ต่างกัน ทำให้การตัดสินใจยากขึ้นในการอ้างเหตุผล
ใครคือกลุ่มเป้าหมาย
คลังงานวิจัยไม่ใช่แค่นักวิจัยเท่านั้น เวอร์ชันที่ดีที่สุดรองรับ:
- นักวิจัย ที่เก็บการสัมภาษณ์และสังเคราะห์รูปแบบ
- ผู้จัดการผลิตภัณฑ์และนักออกแบบ ที่ยืนยันการตัดสินใจด้วยหลักฐาน
- ทีมสนับสนุนและความสำเร็จลูกค้า ที่ป้อนปัญหาจริงของลูกค้าเข้าสู่การทำงานของผลิตภัณฑ์
- ผู้นำ ที่เข้าใจอย่างรวดเร็วว่าสิ่งไหนเป็นจริง สิ่งไหนเปลี่ยน และทำไม
ผลลัพธ์หลัก
เป้าหมายไม่ใช่แค่ "เก็บการสัมภาษณ์" แต่เป็นการ เปลี่ยนการสนทนาดิบให้เป็นข้อค้นพบที่นำกลับมาใช้ซ้ำได้—แต่ละข้อมีคำพูดต้นทาง แท็ก และบริบทพอให้ใครก็ได้ไว้วางใจและนำไปใช้ต่อได้
เริ่มจากเล็ก แล้วค่อยเพิ่มความซับซ้อน
ตั้งความคาดหวังตั้งแต่ต้น: ปล่อย MVP ที่ผู้คนจะใช้งานได้จริง แล้วขยายตามพฤติกรรมจริง เครื่องมือที่เล็กกว่าและเข้าไปอยู่ในงานประจำวัน จะดีกว่าฟีเจอร์แน่นแต่ไม่มีใครอัปเดต
ภาพของ "ดี" เป็นอย่างไร
กำหนดความสำเร็จด้วยเงื่อนไขเชิงปฏิบัติ:
- ใช้เวลาค้นหางานวิจัยเดิมน้อยลง
- ใช้ข้อค้นพบเดิมซ้ำได้มากขึ้นในโปรเจกต์ต่างๆ
- การตัดสินใจชัดเจนและเร็วขึ้นโดยมีคำพูดและหลักฐานหนุน
- ลดการสัมภาษณ์ซ้ำในคำถามที่ตอบแล้ว
เริ่มจากงานของผู้ใช้และ workflow การวิจัย
ก่อนเลือกฟีเจอร์ ให้ชัดว่า งาน ที่ผู้คนพยายามทำคืออะไร แอปสำหรับข้อค้นพบจากการสัมภาษณ์ลูกค้าประสบความสำเร็จเมื่อมันลดแรงเสียดทานตลอดวงจรการวิจัย ไม่ใช่แค่การเก็บโน้ต
งานหลักของผู้ใช้ (สิ่งที่แอปต้องรองรับ)
ทีมส่วนใหญ่ทำงานหลักซ้ำๆ เหล่านี้:
- Capture: นัดหมาย บันทึก โน้ต แนบไฟล์
- Transcribe: นำทรานสคริปต์เข้ามา (ด้วยมือหรืออัตโนมัติ)
- Code/tag: เน้นคำพูด ใช้แท็ก ลิงก์ไปยังธีม
- Synthesize: กลุ่มหลักฐาน เขียน insight ระบุความมั่นใจ
- Share: เผยแพร่สรุป ส่งออก แจ้งผู้มีส่วนได้ส่วนเสีย
งานเหล่านี้ควรเป็นคำศัพท์ของผลิตภัณฑ์ (และนำทางของคุณ)
แม็ปฟลว์จากการสัมภาษณ์สู่ข้อค้นพบ
เขียนเวิร์กโฟลว์เป็นลำดับง่ายๆ จาก “การนัดหมายสัมภาษณ์” ถึง “การตัดสินใจ” ฟลว์ทั่วไปมีลำดับประมาณ:
Scheduling → prep (guide, participant context) → call/recording → transcript → highlighting quotes → tagging → synthesis (insights) → reporting → decision/next steps.
ตอนนี้ให้ระบุจุดที่คนเสียเวลาหรือเสียบริบท ปัญหาทั่วไปได้แก่:
- การส่งต่อ: คนคนหนึ่งสัมภาษณ์ อีกคนมาทำ tagging บริบทหาย
- ข้อมูลซ้ำ: ข้อค้นพบเดียวกันถูกเขียนซ้ำในสไลด์และเอกสาร
- ขาดบริบท: คำพูดไม่มีรายละเอียดผู้เข้าร่วม วันที่ หรือเป้าหมายการวิจัย
- เครื่องมือกระจัดกระจาย: ทรานสคริปต์อยู่ที่หนึ่ง แท็กอยู่ที่อีกที่ รายงานอีกที่
ตัดสินใจว่าแอปคุณเป็นเจ้าของอะไร vs เชื่อมต่อกับอะไร
ระบุขอบเขตอย่างชัดเจน สำหรับ MVP แอปของคุณควรโดยทั่วไป เป็นเจ้าของ repository งานวิจัย (interviews, quotes, tags, insights, การแชร์) และ เชื่อมต่อ กับ:
- ปฏิทินการนัดหมาย (Google/Microsoft)
- การประชุม/บันทึกวิดีโอ (Zoom/Meet/Teams)
- บริการถอดเสียง (นำเข้าไฟล์หรือเชื่อมผ่าน API)
วิธีนี้จะหลีกเลี่ยงการสร้างผลิตภัณฑ์ที่โตเต็มที่ซ้ำซ้อน ในขณะที่ยังส่งมอบ workflow ที่เป็นหนึ่งเดียว
5–8 user stories เพื่อรักษาขอบเขต
ใช้พวกนี้นำทางการสร้างครั้งแรกของคุณ:
- ในฐานะนักวิจัย ฉันสามารถสร้างระเบียนการสัมภาษณ์พร้อมบริบทผู้เข้าร่วมและเป้าหมายได้
- ในฐานะนักวิจัย ฉันสามารถนำเข้าทรานสคริปต์และเชื่อมกับการสัมภาษณ์ได้
- ในฐานะนักวิจัย ฉันสามารถเน้นข้อความแล้วบันทึกเป็น quote ได้
- ในฐานะนักวิจัย ฉันสามารถติดแท็ก quote และรวบรวมภายใต้ธีมได้
- ในฐานะนักวิจัย ฉันสามารถเขียน insight ที่รองรับด้วยหลายๆ quote ได้
- ในฐานะเพื่อนร่วมทีม ฉันสามารถคอมเมนต์ใน insight และขอคำชี้แจงได้
- ในฐานะผู้มีส่วนได้ส่วนเสีย ฉันสามารถดูสรุปที่แชร์ได้โดยไม่แก้ไข
ถ้าฟีเจอร์ไม่รองรับหนึ่งในเรื่องเหล่านี้ มันน่าจะไม่ใช่ขอบเขตวันแรก
กำหนดขอบเขต MVP: ฟีเจอร์ที่ต้องมีในวันแรก
ทางที่เร็วที่สุดที่จะทำให้โปรเจกต์นี้ล้มเหลวคือลองแก้ปัญหาการวิจัยทั้งหมดพร้อมกัน MVP ของคุณควรทำให้ทีมสามารถเก็บการสัมภาษณ์ หาเจอสิ่งที่ต้องการภายหลัง และแชร์ข้อค้นพบโดยไม่สร้างภาระกระบวนการใหม่
เซ็ตฟีเจอร์ใช้งานได้ในวันแรกแบบปฏิบัติ
เริ่มจากชุดเล็กที่สุดที่รองรับ workflow ต่อเนื่อง:
- Projects: ที่สำหรับจัดกลุ่มงานตามริเริ่ม (เช่น “ปรับปรุง Onboarding Q1”).
- Interviews: ระเบียนที่มีรายละเอียดผู้เข้าร่วม วันที่ นักวิจัย และลิงก์/ไฟล์
- Notes + quotes: ชิ้นข้อความที่เน้นได้ (ทำด้วยมือก็พอ) ผูกกับการสัมภาษณ์
- Tags: ทางเรียบง่ายในการติดป้ายธีม บุคลิกผู้ใช้ ปัญหา และฟีเจอร์
- Search + basic filters: ค้นหาข้ามหัวข้อ โน้ต และคำพูด; กรองตามแท็กและโปรเจกต์
- Export/share: แชร์สรุปโปรเจกต์หรือส่งออก quotes/tags เป็น CSV/PDF ให้ผู้มีส่วนได้เห็น
สิ่งที่ต้องมี vs สิ่งที่เป็น nice-to-have
เข้มงวดเกี่ยวกับสิ่งที่จะส่งมอบตอนนี้:
- ต้องมี: capture, tag, search, และ share
- ควรมีทีหลัง: สรุปด้วย AI, การจัดคลัสเตอร์ธีมอัตโนมัติ, การวิเคราะห์ความรู้สึก, แดชบอร์ดขั้นสูง, สรุปใน Slack
ถ้าต้องการ AI ในอนาคต ออกแบบให้รองรับ (เก็บข้อความและเมตาดาต้าที่สะอาด) แต่อย่าให้ MVP ต้องพึ่งมัน
ตั้งข้อจำกัดเพื่อลดความซับซ้อน
เลือกข้อจำกัดที่จะช่วยให้คุณส่งมอบได้:
- รองรับ format ทรานสคริปต์หนึ่งแบบ (เช่น วางข้อความ) ก่อนจะรองรับทุกผู้ให้บริการ
- เริ่มด้วย บทบาทพื้นฐาน (Owner/Admin/Editor/Viewer) แทนสิทธิ์ละเอียด
- ใช้ เทมเพลตโน้ตพื้นฐาน (3–5 ส่วน) แทนบิวเดอร์เทมเพลต
กำหนดเป้าการใช้งานครั้งแรก
ตัดสินใจว่าใครเป็นเป้าหมายแรก: ตัวอย่างเช่น ทีมวิจัย/ผลิตภัณฑ์ 5–15 คน กับ 50–200 การสัมภาษณ์ ในเดือนแรก นี่จะช่วยกำหนดความต้องการประสิทธิภาพ พื้นที่จัดเก็บ และค่าเริ่มต้นสิทธิ์
แผนปล่อยอย่างเรียบง่าย (2–3 milestone)
- Milestone 1: Projects + interviews + notes + tags (core capture).
- Milestone 2: Search/filters + export/share (ทำให้เป็นประโยชน์กับทั้งทีม).
- Milestone 3: ปรับปรุงคุณภาพ (นำเข้าครั้งใหญ่, UX การแท็กที่ดีขึ้น, audit log).
ออกแบบโมเดลข้อมูลสำหรับ Interviews, Quotes, และ Insights
แอปงานวิจัยที่ดีขึ้นอยู่กับโมเดลข้อมูลที่ดี ถ้าคุณโมเดล "insights" เป็นแค่ฟิลด์ข้อความ คุณจะได้กองโน้ตที่ไม่มีใครนำกลับมาใช้ได้ ถ้าทำโมเดลมากเกินไป ผู้คนจะไม่กรอกข้อมูลอย่างสม่ำเสมอ เป้าหมายคือโครงสร้างที่รองรับงานจริง: การจับข้อมูล ความสามารถติดตาม และการนำกลับมาใช้
ออบเจ็กต์หลัก (เซ็ตขั้นต่ำที่มีประโยชน์)
เริ่มจากชุดออบเจ็กต์ระดับแรกเล็กๆ:
- Workspace: ขอบเขตขององค์กร (การเรียกเก็บเงิน การตั้งค่า สมาชิก)
- Project: ความพยายามหรือริเริ่มงานวิจัย
- Interview: เซสชัน (วันที่/เวลา วิธีการ แหล่งที่มา)
- Participant: ผู้ที่คุณพูดด้วย (หรือโปรไฟล์นามแฝง)
- Transcript: ข้อความดิบผูกกับการสัมภาษณ์
- Note: ข้อสังเกตและการตีความของนักวิจัย
- Insight: ข้อสรุปที่ควรนำกลับมาใช้ได้
- Tag: พจนานุกรมร่วมสำหรับการจัดกลุ่ม
ความสัมพันธ์ที่รักษาบริบท
ออกแบบโมเดลเพื่อให้คุณตอบได้เสมอว่า “อันนี้มาจากไหน?”
- Project มีหลาย Interview
- Interview เชื่อมกับ Participant หนึ่งคน (หรือหลายคนถ้าเป็นกลุ่ม)
- Transcript เป็นของ Interview หนึ่งรายการ
- Quote (หรือ excerpt) อยู่ใน Transcript และอาจถูกอ้างโดยหลาย Insight
- Insight เชื่อมกับหนึ่งหรือหลาย Quote และเชื่อมกับ Project (และอาจเชื่อมกับพื้นที่ผลิตภัณฑ์หรือขั้นตอนการเดินทางผ่านแท็ก)
การติดตามต้นทางแบบนี้ทำให้คุณนำ insight ไปใช้ซ้ำได้โดยยังคงหลักฐาน
เมตาดาต้าที่คุณควรมีเร็วกว่าเวลาที่คิด
รวมฟิลด์อย่าง date, researcher, source (ช่องทางสรรหาผู้เข้าร่วม, เซกเมนต์ลูกค้า), language, และ consent status ฟิลด์พวกนี้ช่วยให้กรองและแชร์อย่างปลอดภัยได้ภายหลัง
ไฟล์แนบและสื่อภายนอก
ถือว่าสื่อเป็นส่วนหนึ่งของระเบียน: เก็บ ลิงก์เสียง/วิดีโอ, ไฟล์อัปโหลด, สกรีนช็อต, และ เอกสารที่เกี่ยวข้อง เป็นไฟล์แนบบน Interview (และบางครั้งบน Insight) เก็บสตอเรจยืดหยุ่นเพื่อให้เชื่อมกับเครื่องมืออื่นในภายหลัง
ออกแบบให้เปลี่ยนแปลงได้ (โดยไม่ทำลายประวัติ)
แท็ก เทมเพลต insight และ workflow จะวิวัฒน์ ใช้เทมเพลตเวอร์ชันได้ (เช่น Insight มี “type” และฟิลด์ JSON ทางเลือก) และอย่าลบทิ้งพจนานุกรมที่ถูกแชร์—ให้เลิกใช้ (deprecate) แทน วิธีนี้โปรเจกต์เก่ายังอ่านได้ ขณะที่โปรเจกต์ใหม่มีโครงสร้างที่ดีขึ้น
วางแผน UX: Capture, Tag, Synthesize, Share
คลังงานวิจัยล้มเหลวเมื่อช้ากว่าการจดในสมุด UX ของคุณต้องทำให้ workflow ที่ "ถูก" เป็นเส้นทางที่เร็วที่สุด—โดยเฉพาะระหว่างการสัมภาษณ์สด เมื่อผู้คนทำหลายอย่างพร้อมกัน
ออกแบบเมนูนำทางตามวิธีคิดของทีม
เก็บลำดับชั้นให้คาดเดาได้และมองเห็นได้ชัด:
Workspaces → Projects → Interviews → Insights
Workspaces สะท้อนองค์กรหรือแผนก Projects แม็ปกับริเริ่มผลิตภัณฑ์หรือการศึกษา Interviews เป็นแหล่งข้อมูลดิบ Insights คือสิ่งที่ทีมใช้จริง โครงสร้างนี้ป้องกันปัญหา quote, note, และ takeaway ลอยไปโดยไม่มีบริบท
ทำให้การจับข้อมูลรู้สึกทันที
ระหว่างการโทร นักวิจัยต้องการความเร็วและลดภาระความคิด ให้ความสำคัญกับ:
- Quick notes ที่มีฟิลด์บังคับน้อยที่สุด
- Timestamps (คลิกครั้งเดียวเพื่อแทรก “00:12:34”) เพื่อให้คลิปและคำพูดตามได้
- Speaker labels (Participant, Interviewer, Stakeholder) เพื่อลดการแก้ไขภายหลัง
ถ้าจะเพิ่มฟีเจอร์ที่ขัดการจด ให้ทำเป็นทางเลือกหรือแนะนำอัตโนมัติ
มาตรฐานการสังเคราะห์ด้วย “การ์ด Insight”
เมื่อการสังเคราะห์เป็นแบบอิสระ รายงานจะไม่สม่ำเสมอ รูปแบบการ์ด insight ช่วยให้ทีมเปรียบเทียบผลการค้นพบระหว่างโปรเจกต์ได้:
- Claim: ข้อสรุปเป็นภาษาธรรมดา
- Evidence: quotes หรือตอนที่เชื่อมโยง (มี timestamp)
- Severity / impact: ทำไมมันถึงมีความสำคัญ
- Segment: กลุ่มเป้าหมายที่ใช้ได้ (persona, แผน, บทบาท)
- Confidence: ความเชื่อมั่นตามหลักฐาน
มุมมองที่บันทึกไว้สำหรับการเรียกใช้ประจำวัน
ผู้ใช้ส่วนใหญ่ไม่อยาก "ค้นหา"—พวกเขาต้องการรายการสั้นๆ เสนอ saved views เช่น ตามแท็ก, เซกเมนต์, พื้นที่ผลิตภัณฑ์, และ ช่วงเวลา ปฏิบัติกับมุมมองที่บันทึกเหมือนแดชบอร์ดที่คนกลับมาใช้สัปดาห์ละครั้ง
การแชร์ที่เคารพบริบท
ทำให้การแจกจ่าย insight ง่ายโดยไม่ทำให้เกิดความยุ่งเหยิง ขึ้นอยู่กับสภาพแวดล้อม ให้รองรับ ลิงก์อ่านอย่างเดียว, PDF, หรือรายงานภายในน้ำหนักเบา ชิ้นงานที่แชร์ควรชี้กลับสู่หลักฐานต้นทางเสมอ ไม่ใช่แค่สรุป
สิทธิ์ บทบาท และการทำงานร่วมกันในทีม
สิทธิ์อาจรู้สึกเหมือน "งานแอดมิน" แต่มีผลโดยตรงต่อว่าคลังของคุณจะเป็นแหล่งความจริงที่เชื่อถือได้หรือเป็นโฟลเดอร์รกที่คนหลีกเลี่ยง เป้าหมายคือทำให้ผู้คนมีส่วนร่วมอย่างปลอดภัย และให้ผู้เกี่ยวข้องบริโภค insight โดยไม่เสี่ยง
กำหนดบทบาทชัดเจน (และทำให้คาดเดาได้)
เริ่มด้วยสี่บทบาทและทนต่อการเพิ่มจนกว่าจะเจอกรณีขอบจริง:
- Owner: จัดการการเรียกเก็บเงิน การตั้งค่า workspace ลบโปรเจกต์ และมอบหมายแอดมิน
- Admin: จัดการสมาชิก บทบาท และการตั้งค่าระดับ workspace; เข้าถึงทุกโปรเจกต์ตามค่าเริ่มต้น
- Editor: สร้างและแก้ไข interviews, quotes, insights ในโปรเจกต์ที่เข้าถึงได้
- Viewer: อ่านอย่างเดียว; ค้นหาและส่งออกได้ (ถ้าอนุญาต) แต่ไม่สามารถเปลี่ยนเนื้อหา
ทำให้สิทธิ์ชัดใน UI (เช่น ใน modal เชิญสมาชิก) เพื่อให้คนไม่เดาว่า "Editor" หมายความว่าอะไร
การเข้าถึงระดับ workspace vs ระดับโปรเจกต์
จำลองการเข้าถึงเป็นสองชั้น:
- Workspace-level membership ตอบคำถามว่า: "คนนี้เป็นส่วนหนึ่งของทีมไหม?"
- Project-level access ตอบคำถามว่า: "เขาเห็นและแก้ไขงานวิจัยใดได้บ้าง?"
ค่าเริ่มต้นที่ใช้ง่าย: admins เข้าถึงทุกโปรเจกต์; editors/viewers ต้องถูกเพิ่มในแต่ละโปรเจกต์ (หรือผ่านกลุ่มเช่น “Product”, “Research”, “Sales”). วิธีนี้ป้องกันการแชร์เกินความจำเป็นเมื่อสร้างโปรเจกต์ใหม่
การเข้าถึงแบบ Guest สำหรับผู้มีส่วนได้ส่วนเสียและผู้รับเหมา
ถ้าจำเป็น ให้เพิ่ม Guests เป็นกรณีพิเศษ: เชิญเข้าร่วมเฉพาะโปรเจกต์ที่กำหนดเท่านั้น และไม่ควรเห็นไดเรกทอรี workspace ทั้งหมด พิจารณาการเข้าถึงแบบมีวันหมดอายุ (เช่น หมดอายุใน 30 วัน) และจำกัดการส่งออกสำหรับ guests ตามค่าเริ่มต้น
พื้นฐาน audit ที่คุณจะขอบคุณภายหลัง
ติดตาม:
- ใครสร้าง/แก้ไข interview, quote, หรือ insight
- เวลาเกิดเหตุ
- (ทางเลือก) สิ่งที่เปลี่ยน โดยเฉพาะ insight
สิ่งนี้สร้างความไว้วางใจในรีวิวและทำให้แก้ไขความผิดพลาดได้ง่ายขึ้น
การจัดการการสัมภาษณ์ที่อ่อนไหว
วางแผนข้อมูลจำกัดตั้งแต่วันแรก:
- โปรเจกต์จำกัด ที่มีข้อกำหนดการเป็นสมาชิกเข้มงวด
- โน้ตส่วนตัว มองเห็นได้เฉพาะบทบาทที่กำหนด (หรือผู้เขียน)
- ตัวบ่งชี้ชัดเจนว่าเนื้อหาเป็นข้อมูลอ่อนไหว เพื่อไม่ให้คนวางลงในช่องทางที่กว้าง
การค้นหา ตัวกรอง และการแท็กที่คนจะใช้จริง
การค้นหาคือจุดที่ repository ของคุณจะกลายเป็นเครื่องมือประจำวัน—หรือสุสานโน้ต ออกแบบมันรอบงานดึงข้อมูลจริง ไม่ใช่เป็นแค่ "ช่องค้นหาทุกอย่าง"
เริ่มจากกรณีการค้นหาสำคัญที่สุด
ทีมส่วนใหญ่พยายามหา:
- คำพูดเฉพาะที่จำได้ ("อันที่บอกว่า onboarding งง")
- ข้อค้นพบทั้งหมดที่ผูกกับธีม (เช่น "ความกังวลเรื่องราคา")
- ทุกอย่างจากผู้เข้าร่วม บุคลิก/เซกเมนต์ หรือบริษัท
- การสัมภาษณ์ช่วงวันที่ (เช่น "ไตรมาสที่แล้ว") หรือโปรเจกต์
- โน้ตที่สร้างโดยนักวิจัยคนหนึ่ง หรือรายการที่ต้องทบทวน
ทำให้เส้นทางเหล่านี้เห็นชัดใน UI: ช่องค้นหาธรรมดา + ตัวกรองที่มองเห็นซึ่งสะท้อนภาษาที่คนใช้พูดถึงงานวิจัย
ตัวกรองและการจัดเรียงที่สอดคล้องกับการตัดสินใจ
รวมตัวกรองที่มีมูลค่าสูงแบบกระชับ: tag/theme, product area, persona/segment, researcher, interview/project, date range, และสถานะ (draft, reviewed, published). เพิ่มการจัดเรียงตามความใหม่ วันที่สัมภาษณ์ และ "แท็กที่ใช้บ่อย".
กฎที่ดี: ตัวกรองแต่ละอันควรลดความกำกวม ("แสดง insights เกี่ยวกับ onboarding สำหรับผู้ดูแลระบบ SMB, Q3, ทบทวนแล้ว").
การค้นหาข้อความเต็ม + แนวทางสำหรับการแท็ก
รองรับ full-text search ข้ามโน้ตและทรานสคริปต์ ไม่ใช่แค่หัวข้อ ให้คนค้นหาใน quotes และเห็นคำที่ตรงไฮไลท์ พร้อมพรีวิวด่วนก่อนเปิดบันทึกเต็ม
สำหรับแท็ก ความสม่ำเสมอชนะความคิดสร้างสรรค์:
- แนะนำแท็กที่มีอยู่ขณะพิมพ์
- ป้องกันการทำซ้ำง่ายๆ (ไม่แยกตัวพิมพ์ใหญ่/เล็ก, ตัดช่องว่าง, เตือนเมื่อเกือบซ้ำ)
- อนุญาต alias หรือรวม (เช่น “on-boarding” → “onboarding”)
แผนการประสิทธิภาพสำหรับ workspaces ที่เติบโต
การค้นหาต้องเร็วเมื่อทรานสคริปต์เพิ่มขึ้น ใช้การแบ่งหน้าโดยค่าเริ่มต้น ดัชนีฟิลด์ที่ค้นหาได้ (รวมทรานสคริปต์) และแคชคิวรีที่พบบ่อยเช่น “recent interviews” หรือ “top tags.” การค้นหาช้าเป็นฆาตกรการนำมาใช้แบบเงียบๆ
การรายงานและการนำ insight ไปใช้ข้ามโปรเจกต์
คุณไม่ได้สร้าง "เครื่องสร้างรายงาน" แต่สร้างระบบที่เปลี่ยนหลักฐานจากการสัมภาษณ์ให้เป็นผลลัพธ์ที่แชร์ได้—และทำให้ผลลัพธ์เหล่านั้นยังใช้ได้เดือนต่อมา เมื่อมีคนถาม: “ทำไมเราถึงตัดสินใจนั้น?”
กำหนดผลลัพธ์ที่ผู้คนต้องการจริงๆ
เลือกชุดเล็กๆ ของฟอร์แมตการรายงานและทำให้มันสม่ำเสมอ:
- รายงาน insight (สำหรับการศึกษาหนึ่งครั้ง)
- สรุปโปรเจกต์ (เรื่องราวหน้าเดียวสำหรับผู้มีส่วนได้ส่วนเสีย)
- บอร์ดธีม (จัดกลุ่ม insights ตามธีมพร้อมคำพูดรองรับ)
- สรุปรายสัปดาห์ (insights ใหม่ + การตัดสินใจ ส่งไปยัง Slack/email ในภายหลัง)
แต่ละฟอร์แมตควรถูกสร้างจากออบเจ็กต์เดียวกัน (interviews → quotes → insights) ไม่ใช่การคัดลอกเป็นเอกสารแยกต่างหาก
ใช้เทมเพลตน้ำหนักเบาเพื่อรักษาคุณภาพ
เทมเพลตช่วยป้องกัน "รายงานว่างเปล่า" และทำให้การศึกษาเทียบกันได้ เก็บให้สั้น:
- คำถามการวิจัย
- วิธีการ (สัมภาษณ์, usability test ฯลฯ)
- ตัวอย่าง (ใครพูดกี่คน)
- ข้อค้นพบหลัก (3–7 ข้อ)
- คำพูดเด่น (มีลิงก์กลับสู่ต้นทาง)
เป้าหมายคือความเร็ว: นักวิจัยควรเผยแพร่สรุปชัดเจนได้ในไม่กีนาที ไม่ใช่เป็นชั่วโมง
ทำให้การติดตามที่มาของข้อมูลเป็นเรื่องไม่ต่อรอง
ทุก insight ควรลิงก์กลับสู่ หลักฐาน:
- อย่างน้อยหนึ่ง quote (และถ้าเป็นไปได้หลายอัน)
- การสัมภาษณ์ที่มาของมัน
- เมตาดาต้าเช่น ชนิดผู้เข้าร่วม วันที่ และโปรเจกต์
ใน UI ให้ผู้อ่านคลิก insight เพื่อเปิด quotes ที่รองรับและกระโดดไปยังช่วงทรานสคริปต์ที่เฉพาะเจาะจง สิ่งนี้สร้างความเชื่อมั่น—และป้องกันไม่ให้ "insights" กลายเป็นความเห็นส่วนตัว
ส่งออกโดยไม่เสียบริบท
ผู้มีส่วนได้ส่วนเสียจะขอ PDF/CSV สนับสนุนการส่งออก แต่ใส่ตัวระบุและลิงก์กลับ:
- Insight ID, theme, confidence/status
- ข้อความย่อของ quote และอ้างอิงการสัมภาษณ์ต้นทาง
- เส้นทางอ้างอิงกลับสู่แอป (เช่น /projects/123/insights/456)
เปลี่ยน insights ให้เป็นการตัดสินใจ
ตัดสินใจว่าข้อค้นพบจะกลายเป็นการกระทำอย่างไร workflow ง่ายๆ ก็พอ:
- Status: proposed → accepted → in progress → done
- Owner: ผู้รับผิดชอบ
- Follow-ups: งานทดลอง หรือคำถามที่เปิดอยู่
สิ่งนี้ปิดวง: ข้อค้นพบไม่ได้แค่ถูกเก็บ แต่เป็นตัวขับเคลื่อนผลลัพธ์ที่ติดตามได้และนำกลับมาใช้ข้ามโปรเจกต์
การเชื่อมต่อและการนำเข้าข้อมูลโดยไม่ให้เกิดปัญหา
คลังงานวิจัยมีประโยชน์ก็ต่อเมื่อมันเข้าไปอยู่ในเครื่องมือที่ทีมใช้จริง เป้าหมายไม่ใช่ "เชื่อมทุกอย่าง" แต่เป็นการเอาอุปสรรคหลักออก: นำเซสชันเข้ามา, นำทรานสคริปต์เข้ามา, และนำ insights ออกไป
การเชื่อมต่อที่คนคาดหวัง
เริ่มจากการเชื่อมต่อเบาๆ ที่รักษาบริบท มากกว่าพยายามซิงก์ทั้งระบบ:
- การโทรวิดีโอ: เก็บลิงก์การบันทึก Zoom/Google Meet ข้างๆ แต่ละ Interview
- ปฏิทิน: ดึงเมตาดาต้าการสัมภาษณ์ (หัวข้อ, วันที่/เวลา, ผู้เข้าร่วม) จาก Google/Microsoft
- การถอดเสียง: ยอมรับไฟล์/การส่งออกจากเครื่องมือทั่วไป หรือเชื่อมต่อผู้ให้บริการถอดเสียงภายหลัง
- เอกสาร: ลิงก์ไปยังโน้ตต้นฉบับใน Google Docs/Notion/Confluence
- แชท: ส่งอัปเดตไปที่ Slack/Microsoft Teams เมื่อมีสิ่งสำคัญเปลี่ยน
เส้นทางนำเข้า: เลือก 2–3 ไม่ใช่ 10
ให้ทาง "happy path" ชัดเจนและมีทางสำรอง:
- ป้อนด้วยมือ สำหรับการสัมภาษณ์ครั้งเดียว (เร็วและยืดหยุ่น)
- อัปโหลด CSV สำหรับการย้ายข้อมูลจากสเปรดชีตจำนวนมาก
- API/Webhook สำหรับผู้ใช้ระดับสูงและการทำงานอัตโนมัติในอนาคต
เก็บวัตถุดิบดิบไว้: เก็บ ลิงก์ต้นทาง และอนุญาตให้ดาวน์โหลดไฟล์ที่อัปโหลด วิธีนี้ทำให้ง่ายต่อการย้ายเครื่องมือและลดการล็อกกับผู้ให้บริการ
การแจ้งเตือนที่ช่วยได้ (ไม่ใช่สแปม)
รองรับเหตุการณ์ที่มีสัญญาณสูงไม่กี่อย่าง: สร้าง insight ใหม่, @mention, เพิ่มคอมเมนต์, และ เผยแพร่รายงาน ให้ผู้ใช้ควบคุมความถี่ (ทันที vs สรุปรายวัน) และช่องทาง (email vs Slack/Teams)
เอกสารจำกัดการเชื่อมต่อตั้งแต่แรก
สร้างหน้า /help/integrations ที่ระบุรูปแบบที่รองรับ (เช่น .csv, .docx, .txt), สมมติฐานทรานสคริปต์ (speaker labels, timestamps), และข้อจำกัดการเชื่อมต่อเช่น rate limits, ขนาดไฟล์สูงสุด, และฟิลด์ที่นำเข้าแล้วไม่สะอาด
ความเป็นส่วนตัว การยินยอม และความปลอดภัยที่จำเป็น
ถ้าคุณเก็บโน้ตการสัมภาษณ์ บันทึก และคำพูด คุณกำลังจัดการวัสดุที่อ่อนไหว—แม้จะเป็น "แค่คำติชมธุรกิจ" ก็ตาม ปฏิบัติต่อความเป็นส่วนตัวและความปลอดภัยเป็นฟีเจอร์หลัก ไม่ใช่เรื่องรอง
ติดตามการยินยอมเป็นข้อมูลเชิงโครงสร้าง
อย่าฝังการยินยอมในโน้ต เพิ่มฟิลด์ชัดเจนเช่น consent status (pending/confirmed/withdrawn), capture method (signed form/verbal), date, และ usage restrictions (เช่น “ไม่อนุญาตให้ใช้คำพูดโดยตรง”, “ใช้ภายในเท่านั้น”, “ใช้การตลาดได้เมื่อทำให้เป็นนามธรรมแล้ว”).
ทำให้ข้อจำกัดเหล่านี้มองเห็นได้ทุกที่ที่ quotes ถูกนำไปใช้ โดยเฉพาะในการส่งออกและรายงาน เพื่อไม่ให้ทีมเผยแพร่เนื้อหาที่ไม่ควร
ลดข้อมูลส่วนบุคคลที่เก็บไว้
ตั้งค่าเริ่มต้นให้เก็บเฉพาะสิ่งที่สนับสนุนการวิจัย บ่อยครั้งคุณไม่จำเป็นต้องเก็บชื่อจริง, อีเมลส่วนตัว, หรือชื่อตำแหน่งที่ละเอียด พิจารณา:
- นามแฝงผู้เข้าร่วม (เช่น “P12”) ร่วมกับบริษัทและประเภทบทบาท
- แยกฟิลด์ "ข้อมูลติดต่อ" กับ "ข้อมูลการวิจัย" โดยให้การเข้าถึงข้อมูลติดต่อเข้มงวดกว่า
- การลบชื่อ/ข้อมูลจำเพาะในโน้ตเป็นทางเลือก
ปกป้องข้อมูลตั้งแต่ต้นทางถึงปลายทาง
ครอบคลุมพื้นฐานให้ดี:
- การเข้ารหัสขณะส่ง (HTTPS ทุกที่)
- เก็บรหัสผ่านอย่างปลอดภัย (salted hashing ผ่านไลบรารียืนยันตัวตนที่เชื่อถือได้)
- บันทึกการเข้าถึง สำหรับการกระทำที่อ่อนไหว (ส่งออก, เปลี่ยนบทบาท, ลบ)
ตั้งค่าเริ่มต้นแบบ least-privilege: เฉพาะบทบาทที่เหมาะสมเท่านั้นควรเห็นการบันทึกดิบหรือข้อมูลติดต่อผู้เข้าร่วม
การเก็บรักษา ลบ และการทำความสะอาด
การเก็บรักษาเป็นการตัดสินใจของผลิตภัณฑ์ เพิ่มคอนโทรลง่ายๆ เช่น “archive project”, “delete participant”, และ “delete on request”, พร้อมนโยบายสำหรับโปรเจกต์เฉื่อย (เช่น archive หลัง 12 เดือน). ถ้าสนับสนุนการส่งออก ให้บันทึกการส่งออกและพิจารณาลิงก์ดาวน์โหลดที่หมดอายุ
ความพร้อมเชิงปฏิบัติการ
แม้แต่ MVP ก็ต้องมีตาข่ายนิรภัย: สำรองอัตโนมัติ, วิธีกู้คืน, คอนโทรลแอดมินเพื่อปิดบัญชี, และเช็คลิสต์ตอบสนองเหตุการณ์พื้นฐาน (แจ้งใคร, ต้องหมุนอะไร, ต้องตรวจอะไร) การเตรียมนี้ป้องกันความผิดพลาดเล็กๆ ให้ไม่กลายเป็นเหตุการณ์ใหญ่
สถาปัตยกรรมและการเลือกเทคโนโลยี (ให้ง่ายไว้)
สถาปัตยกรรมที่ดีที่สุดสำหรับแอป insight งานวิจัยคืออันที่ทีมคุณสามารถส่งมอบ ดูแล และเปลี่ยนแปลงได้โดยไม่กลัว ตั้งเป้าหมายไปที่ฐานที่น่าเชื่อถือและเข้าใจง่าย: เว็บแอปตัวเดียว, ฐานข้อมูลหนึ่งชุด, และบริการจัดการไม่กี่ตัว
สแต็กเริ่มต้นที่ใช้ได้จริง
เลือกเทคโนโลยีที่ทีมคุ้นเคย ตัวเลือกที่พบได้บ่อยและมี friction ต่ำ:
- Web framework: Rails, Django, Laravel, หรือ Node (Express/Nest). มอนอลิธตัวเดียวก็เพียงพอ
- Database: Postgres (ดีสำหรับข้อมูลมีโครงสร้างและการกรอง)
- Search: เริ่มด้วย Postgres full-text search; เพิ่ม OpenSearch/Meilisearch เมื่อเจ็บจริง
- File storage (เสียง, ทรานสคริปต์): ที่เก็บอ็อบเจ็กต์แบบ S3-compatible
วิธีนี้ทำให้การ deploy และ debug ง่าย ในขณะที่ยังขยายได้
โมดูลหลักที่ต้องสร้างก่อน
เก็บ surface area ของ "วันหนึ่ง" ให้เล็ก:
- Auth (อีเมล + magic link หรือ SSO ภายหลัง)
- Projects (workspaces สำหรับริเริ่มการวิจัย)
- Interviews (เมตาดาต้า + ทรานสคริปต์ + ไฟล์แนบ)
- Insights/quotes (ชิ้นข้อความที่เน้นผูกกับการสัมภาษณ์)
- Tagging (แท็ก ธีม ฟิลด์กำหนดเอง)
- Reporting (คอลเล็กชัน insight แบบง่ายและการส่งออก)
API: ชัดเจน น่าเบื่อ และสม่ำเสมอ
REST มักเพียงพอ ถ้าเลือก GraphQL ให้แน่ใจว่าทีมถนัดและจำเป็นจริงๆ
- Versioning: เริ่มไม่ version; แนะนำ /api/v1 เมื่อต้องรองรับลูกค้าภายนอก
- Error handling: รูปแบบข้อผิดพลาดสม่ำเสมอ (message, code, details) และข้อผิดพลาดการตรวจสอบที่ผู้ใช้แก้ได้
โปรโตไทป์เร็วโดยไม่ผูกติดกับสแต็กสุดท้าย
ถ้าต้องการยืนยัน workflow ก่อนลงทุนเต็มที่ แพลตฟอร์มโค้ดเร็วอย่าง Koder.ai ช่วยให้คุณโปรโตไทป์ MVP จากสเป็กแบบแชทได้เร็ว—โดยเฉพาะ CRUD พื้นฐาน (projects, interviews, quotes, tags), การเข้าถึงตามบทบาท, และ UI การค้นหา ทีมมักใช้วิธีนี้เพื่อได้พิลอตที่คลิกได้เร็วก่อนส่งออกซอร์สโค้ดและทำให้แข็งแรงสำหรับ production
สิ่งแวดล้อมและข้อมูลเริ่มต้น
ใช้ local → staging → production ตั้งแต่เริ่ม
ใส่ข้อมูลตัวอย่างใน staging (โปรเจกต์/การสัมภาษณ์จริงจังแบบ realistic) เพื่อทดสอบการค้นหา สิทธิ์ และการรายงานอย่างรวดเร็ว
การสังเกตการณ์ (อย่าข้าม)
เพิ่มพื้นฐานตั้งแต่ต้น:
- logs มีโครงสร้าง (request id, user id, project id)
- metrics ง่ายๆ (response times, job failures)
- การติดตามข้อผิดพลาด (Sentry หรือคล้ายกัน)
สิ่งเหล่านี้ช่วยประหยัดชั่วโมงเมื่อบางอย่างพังในสปรินต์การวิจัยจริงครั้งแรก
การทดสอบ การปล่อย และการวนปรับหลัง MVP
MVP ของคุณไม่ "เสร็จ" เมื่อฟีเจอร์ปล่อย แต่เสร็จเมื่อทีมจริงสามารถเปลี่ยนการสัมภาษณ์เป็นข้อค้นพบและนำไปใช้ในตัดสินใจได้ นั่นหมายความว่าการทดสอบและการปล่อยต้องมุ่งที่ว่า workflow หลักทำงาน end-to-end หรือไม่ ไม่ใช่ทุกกรณีขอบจะสมบูรณ์
ทดสอบฟลว์ที่สำคัญ
ก่อนกังวลเรื่องสเกล ให้ทดสอบลำดับที่คนจะทำซ้ำทุกสัปดาห์:
- สร้าง interview (ผู้เข้าร่วม, วันที่, โปรเจกต์, สถานะยินยอม)
- เพิ่มโน้ตหรือทรานสคริปต์และดึง quotes สักสองสามอัน
- ติดแท็ก quotes และโปรโมตเป็น insights
- ค้นหาด้วยแท็ก/หัวข้อและเจอสิ่งที่มีประโยชน์เร็วๆ
- แชร์รายงานสั้นกับเพื่อนร่วมทีมหรือผู้มีส่วนได้เห็น
ใช้เช็คลิสต์เบาๆ แล้วรันทุกครั้งที่ปล่อย ถ้าขั้นตอนไหนสับสนหรือช้า การนำไปใช้จะลดลง
ยืนยันด้วยข้อมูลตัวอย่างตั้งแต่ต้น
อย่าทดสอบบนหน้าจอว่าง นำข้อมูลตัวอย่างใส่แอปด้วย interviews, quotes, tags, และ 2–3 รายงานง่ายๆ ช่วยยืนยันโมเดลข้อมูลและ UX อย่างรวดเร็ว:
- แท็กยากเกินไปไหมที่จะใช้สม่ำเสมอ?
- คนเข้าใจความแตกต่างระหว่าง quote และ insight ไหม?
- คนใหม่หาคำว่า “pricing confusion” ทั้งหมดได้ภายในนาทีหรือไม่?
ถ้าคำตอบคือ "ไม่" แก้ปัญหานั้นก่อนเพิ่มฟีเจอร์ใหม่
เปิดตัวเป็นพิลอต (แล้วขยาย)
เริ่มกับทีมหนึ่ง (หรือโปรเจกต์เดียว) ใน 2–4 สัปดาห์ ตั้งพิธีรีวิวข้อเสนอแนะประจำสัปดาห์: 20–30 นาทีเพื่อทบทวนสิ่งที่บล็อกผู้คน สิ่งที่อยากได้ และสิ่งที่ถูกละเลย เก็บ backlog ง่ายๆ และส่งอัปเดตเล็กๆ ทุกสัปดาห์—นี่สร้างความไว้วางใจว่าเครื่องมือจะดีขึ้นต่อเนื่อง
วัดการนำไปใช้ ไม่ใช่แค่การใช้งาน
ติดตามสัญญาณที่บอกว่าแอปกลายเป็นส่วนหนึ่งของ workflow การวิจัย:
- ผู้ใช้แอคทีฟรายสัปดาห์ (แยกตามบทบาท: นักวิจัย, PMs, นักออกแบบ)
- การสัมภาษณ์ที่สร้างและเสร็จ
- Quotes ที่ติดแท็กและ insights ที่สร้าง
- คำค้นที่ทำและว่ามีการคลิกผลลัพธ์หรือไม่
- รายงานที่ถูกดู/แชร์
เมตริกเหล่านี้เผยจุดที่ workflow แตก เช่น มีการสัมภาษณ์เยอะแต่ insight น้อย มักหมายความว่าการสังเคราะห์ยากเกินไป ไม่ใช่ว่าข้อมูลไม่พอ
วางแผนรอบถัดไป (AI เป็นตัวเลือก)
การวนปรับครั้งที่สองควรเสริมพื้นฐาน: การแท็กที่ดีขึ้น, ตัวกรองบันทึก, เทมเพลตรายงาน, และการอัตโนมัติเล็กๆ (เตือนให้เพิ่มสถานะยินยอม) ควรพิจารณาฟีเจอร์ AI เมื่อข้อมูลสะอาดและทีมตกลงคำนิยามแล้ว ไอเดียที่เป็นประโยชน์เป็นแบบ "ทางเลือก": แนะนำแท็ก, ตรวจจับ insight ซ้ำ, และสรุปรายร่าง—เสมอกับวิธีแก้ไขและ override ได้ง่าย
คำถามที่พบบ่อย
What’s the smallest MVP feature set for a customer interview insights app?
เริ่มจาก workflow เล็กที่สุดที่ทำให้ทีมเปลี่ยนจาก interview → quotes → tags → insights → การแชร์ ได้จริงๆ.
ชุดฟีเจอร์ที่ใช้งานได้ในวันแรกคือ:
- Projects
- Interviews (metadata + ไฟล์แนบ/ลิงก์)
- Transcript หรือการป้อนโน้ต
- ข้อความที่เน้นเป็น quotes
- Tags + ตัวกรองพื้นฐาน
- การค้นหาข้ามโน้ต/quotes
- แชร์/ส่งออก (ลิงก์อ่านอย่างเดียวหรือ CSV/PDF)
What data model prevents the repository from becoming just a pile of notes?
มองให้องค์ประกอบของ insights เป็นออบเจ็กต์ชั้นหนึ่งที่ต้องมีหลักฐานรองรับ.
โครงสร้างขั้นต่ำที่ดีคือ:
- Interview (วันที่, คนทำงานวิจัย, วิธีการ)
- Participant (มักเป็นนามแฝง)
- Transcript (ข้อความดิบ)
- Quote/excerpt (ข้อความ + เวลาโดยประมาณ)
- Insight (ข้อสรุป + ลิงก์ไปยังหนึ่งหรือหลาย quote)
- Tag (พจนานุกรมร่วม)
โครงนี้ช่วยให้ตอบคำถามได้เสมอว่า: “Insight นี้มาจากไหน?”
How do you keep tagging consistent across a team?
จัดการ tag ให้เป็นพจนานุกรมควบคุม ไม่ใช่ข้อความอิสระ.
แนวทางที่ช่วยได้:
- ใส่ autocomplete ของ tag ที่มีอยู่ขณะพิมพ์
- ป้องกันการซ้ำ (ไม่แยกตัวพิมพ์ใหญ่/เล็ก, ตัดช่องว่าง)
- ให้ฟีเจอร์รวม/alias (เช่น “on-boarding” → “onboarding”)
- เริ่มด้วย taxonomy เริ่มต้นขนาดเล็ก (themes, personas, product areas) แล้วขยายเมื่อจำเป็น
What should search and filters include on day one?
ออกแบบการค้นหาตามงานค้นหาจริง แล้วเพิ่มเฉพาะตัวกรองที่ลดความกำกวม.
ตัวกรองที่ควรมีในวันแรก:
- Tag/theme
- Project
- ช่วงวันที่ (วันสัมภาษณ์)
- Persona/segment
- Researcher
- สถานะ (draft/reviewed/published)
รองรับการค้นหาข้อความเต็ม (full-text) ข้าม notes, quotes, transcripts พร้อมไฮไลท์คำที่ตรงและพรีวิวเร็วๆ ก่อนเปิดบันทึกเต็ม.
How should permissions and roles work for an early version?
ตั้งค่าเริ่มต้นเป็นบทบาทเรียบง่ายและแยกการเข้าถึงตามโครงการจากการเป็นสมาชิก workspace.
การตั้งค่าวิธีปฏิบัติที่แนะนำ:
- Owner/Admin: จัดการ workspace + เข้าถึงทุกอย่าง
- Editor: สร้าง/แก้ไข interviews, quotes, insights (ในโปรเจกต์ที่เข้าถึงได้)
- Viewer: อ่านอย่างเดียว (อาจอนุญาตให้ส่งออก)
ใช้การเข้าถึงแบบระดับโปรเจกต์เพื่อป้องกันการแชร์มากเกินไปเมื่อสร้างงานวิจัยใหม่
What privacy and consent features are essential even in an MVP?
อย่าซ่อนการยินยอมในโน้ต—เก็บเป็นฟิลด์เชิงโครงสร้าง.
อย่างน้อยต้องติดตาม:
- Consent status (pending/confirmed/withdrawn)
- วิธีการเก็บยินยอม (verbal/signed)
- วันที่
- ข้อจำกัดการใช้งาน (เช่น “ไม่อนุญาตให้ใช้คำพูดโดยตรง”)
จากนั้นแสดงข้อจำกัดเหล่านี้ทุกที่ที่มีการนำ quotes ไปใช้ (รายงาน/การส่งออก) เพื่อป้องกันการเผยแพร่ข้อมูลที่อ่อนไหวโดยไม่ตั้งใจ.
Which integrations matter most, and what should the app “own”?
ให้แอปเป็นเจ้าของออบเจ็กต์ repository แต่เชื่อมต่อกับเครื่องมือที่มีอยู่แทนการสร้างใหม่.
การเชื่อมต่อเริ่มต้นที่ควรมี:
- ข้อมูลปฏิทิน (Google/Microsoft)
- ลิงก์การประชุม/บันทึก (Zoom/Meet/Teams)
- นำเข้า transcript (ไฟล์หรือวางข้อความ)
- การแจ้งเตือน Slack/Teams (เฉพาะเหตุการณ์สำคัญ)
เก็บลิงก์ต้นทางและรหัสอ้างอิงเพื่อรักษาบริบทโดยไม่ต้องทำการซิงก์หนักๆ
How do you turn raw interviews into reusable insights (not just summaries)?
มาตรฐานการสังเคราะห์ด้วย “การ์ด insight” จะทำให้ findings เปรียบเทียบกันได้และนำกลับมาใช้ซ้ำได้.
เทมเพลตที่เป็นประโยชน์:
- Claim (ข้อสรุปเป็นภาษาธรรมดา)
- Evidence (quotes ที่เชื่อมโยง + timestamps)
- Impact/severity
- Segment/persona
- Confidence
วิธีนี้ลดความไม่สอดคล้องในการรายงานและทำให้คนที่ไม่ใช่นักวิจัยเชื่อถือผลได้ง่ายขึ้น.
What reporting formats encourage insight reuse across projects?
เลือกฟอร์แมตการรายงานเล็กๆ แต่สม่ำเสมอที่สร้างจากออบเจ็กต์เดียวกัน (interviews → quotes → insights).
รูปแบบที่ใช้ได้จริง:
- Project summary (หน้าพร้อมสรุป)
- Insight report (3–7 ข้อค้นพบ)
- Theme board (จัดกลุ่ม insights ตามธีม)
ถ้าสนับสนุนการส่งออก ให้รวมตัวระบุและ deep links เช่น /projects/123/insights/456 เพื่อรักษาบริบทไว้เมื่ออยู่นอกแอป.
What architecture and tech choices work best to ship and iterate quickly?
เริ่มจากสแต็กที่เข้าใจได้และง่ายต่อการปฏิบัติ จงเพิ่มบริการเฉพาะเมื่อมีความจำเป็นจริง.
แนวทางที่พบบ่อย:
- แอปเว็บแบบมอนอลิธ (Rails/Django/Laravel/Nest)
- Postgres สำหรับข้อมูลหลัก
- ใช้ Postgres full-text search ก่อน; เพิ่ม OpenSearch/Meilisearch เมื่อเจอปัญหาจริง
- ที่เก็บไฟล์แบบ S3-compatible สำหรับไฟล์เสียง/ทรานสคริปต์
เพิ่ม observability ตั้งแต่ต้น (logs มีโครงสร้าง, error tracking) เพื่อไม่ให้พิลอตติดขัดเพราะดีบักยาก.